データビジュアライゼーション(データ可視化)とは、数値やテキストの集まりを、位置・長さ・色などの視覚的な要素に置き換えて、比較・推移・分布・関係を読み取れるようにすることです。この記事では、意味と事例、作り方の手順とグラフの選び方、誤解を招く表現とAIを使うときの注意点を、原典や公式資料に当たって整理します。
まとめ:データビジュアライゼーションの要点
- データビジュアライゼーションは、データを視覚要素に置き換えて「何と何を比べるか」を読み手に渡す技術です。BIはその可視化を業務の意思決定に組み込む仕組み全体を指します。
- 作るときは、問いを1文で書く、データを確かめる、形を選ぶ、強調を1つに絞る、第三者に読ませて確かめる、の順で進めます。
- グラフの種類は見た目でなく目的で決めます。比較は棒グラフ、推移は折れ線グラフ、分布はヒストグラムや箱ひげ図、2変数の関係は散布図、量の流れはサンキー図が基本です。
- クリーブランドとマギル(1984)の実験では、共通の目盛り上の位置で読む判断が、長さより1.4〜2.5倍、円グラフの角度より1.96倍正確でした。
- 棒グラフの縦軸を0以外から始めると差が誇張されます。102と108の比は1.06倍ですが、100起点で描くと棒の長さの比は4倍に見えます。
- AIが作ったグラフも、軸の起点・集計の定義・グラフの種類を人が確かめます。t-SNEなどの2次元マップは、クラスタの大きさや離れ具合をそのまま読まないのが原則です。
データビジュアライゼーションの意味と、BI・ダッシュボードとの違い
英語の data visualization をカタカナにした言葉で、日本語では「データ可視化」とほぼ同じ意味で使われます。研究分野では、CT画像や流体シミュレーションのように物理的な空間を持つデータを描く科学技術の可視化(scientific visualization)と、売上やアンケート結果のように空間を持たない抽象的なデータを描く情報の可視化(information visualization)に分けて扱われます。ビジネスで「データビジュアライゼーション」と言うときは、後者を指すのが普通です。
BI(ビジネスインテリジェンス)との関係は、部品と仕組みの関係です。BIはデータの収集・統合・集計から、可視化、共有、意思決定への反映までを含む取り組み全体で、データビジュアライゼーションはその中の「見せる」工程を担います。BIの定義や導入判断はBIとは?ビジネスインテリジェンスの意味・仕組みから導入判断まで解説で扱っています。
ダッシュボードは、複数のグラフや指標を1画面に並べて定期的に見るための画面です。可視化の成果物の一形態であって、1枚のグラフで答えが出る問いにダッシュボードを作る必要はありません。
データビジュアライゼーションの事例:18世紀の古典から感染症ダッシュボードまで
18〜19世紀に生まれた古典的な事例
現在使われている基本的なグラフの多くは、18〜19世紀に統計や公衆衛生の議論のために考案されました。「何を主張するためにどの形を選んだか」を見ると、設計の考え方がわかります。
| 年 | 作者 | 作品 | 表した内容 |
|---|---|---|---|
| 1786 | ウィリアム・プレイフェア | The Commercial and Political Atlas | 英国の輸出入の推移(折れ線)・相手国別の輸出入(横棒) |
| 1801 | ウィリアム・プレイフェア | The Statistical Breviary | 領土の大陸別の内訳(円) |
| 1855 | ジョン・スノウ | On the Mode of Communication of Cholera | 1854年のコレラ死者の位置 |
| 1858 | フローレンス・ナイチンゲール | 英国陸軍の衛生に関する報告書の付図 | 月別の死因(鶏頭図) |
| 1869 | シャルル・ミナール | ナポレオンのロシア遠征図 | 兵力・経路・方向・気温・日付 |
プレイフェアの1786年と1801年の2冊には、時間を横軸にとった輸出入の線、相手地域別の横棒、領土を大陸別に分けた円がそろっており、いまの折れ線グラフ・棒グラフ・円グラフの原型になっています。
スノウは1855年刊の著書に、1854年8月19日〜9月30日のロンドン、ブロード・ストリート周辺のコレラによる死者を家ごとに印で示した地図を収め、死者が井戸の周りに集中していることを見せました。位置を軸にすると原因の候補が絞れるという、地図による可視化の典型例です。
ナイチンゲールの鶏頭図(ポーラーエリア図)は、1858年刊の英国陸軍の衛生と病院運営に関する報告書の付図で、クリミア戦争中の死者を月ごとの扇形で示しました。青(伝染性の疾病)の面積が赤(負傷)を大きく上回り、負傷より疾病で亡くなった兵士のほうがはるかに多いことがひと目でわかります。衛生改善を訴えるために、データを主張の根拠として使った事例です。
ミナールの図は、兵力を帯の太さで、経路を地図上の位置で、退却時の気温を下部の折れ線で表しています。エドワード・タフテは、この図が兵力・2次元の位置・進行方向・気温・日付の6つの変数を1枚に収めていると数え、多変量を統合した代表例として取り上げました。
2000年以降の事例:動くグラフと感染症ダッシュボード
| 時期 | 事例 | 特徴 |
|---|---|---|
| 2006年2月 | ハンス・ロスリングのTED講演 | Gapminder Worldの動くバブルチャート |
| 2020年1月〜2023年3月 | ジョンズ・ホプキンス大学のCOVID-19ダッシュボード | 世界の感染データを地図と推移で毎日更新 |
| 2020年3月〜 | 東京都 新型コロナウイルス感染症対策サイト | ソースコードをMITライセンスで公開 |
公衆衛生学者のハンス・ロスリングは、2006年2月のTED講演「The best stats you’ve ever seen」で、国ごとの指標の変化を年を追って動くバブルチャートで見せました。Gapminderの説明によると、講演で使われたのはGapminder Worldを動かすアニメーションソフトウェアで、その基盤技術がTrendalyzerです。年ごとの指標の変化をバブルの動きで連続的に見せ、国ごとの推移を追えるようにした点が、この事例の要点です。
ジョンズ・ホプキンス大学のCOVID-19ダッシュボードは2020年1月22日に公開され、世界の感染者数を地図と推移のグラフで毎日更新しました。同大学は2023年3月10日でデータの収集を終えています。日本では、東京都の委託を受けた一般社団法人コード・フォー・ジャパンが開発した東京都 新型コロナウイルス感染症対策サイトが2020年3月3日に公開され、ソースコードはGitHubのTokyo-Metro-Gov/covid19でMITライセンスにより公開されています。
毎日更新するダッシュボードは、データを集め続ける体制とセットでしか成り立ちません。社内で作るときも、誰がいつ更新し、いつ更新をやめるかをグラフの設計より先に決めます。
数表よりグラフで伝わる理由:アンスコムの例と知覚の精度
平均・分散・相関が同じでも形が違うデータ
統計学者のフランシス・アンスコムは1973年、The American Statistician 誌の論文「Graphs in Statistical Analysis」で、平均・分散・相関係数・回帰直線がほぼ同じなのに、散布図にするとまったく違う形になる4組のデータを示しました(アンスコムの例、Anscombe’s quartet)。直線、曲線、1点の外れ値が傾きを引っ張る直線、xがほぼ一定で1点だけ離れた形の4つです。
次のコードは、Python標準の statistics モジュールで4組の要約統計を計算します(correlation と linear_regression はPython 3.10以降で使えます)。
from statistics import mean, variance, correlation, linear_regression

x = [10, 8, 13, 9, 11, 14, 6, 4, 12, 7, 5]
x4 = [8, 8, 8, 8, 8, 8, 8, 19, 8, 8, 8]
ys = {
    "I":   (x,  [8.04, 6.95, 7.58, 8.81, 8.33, 9.96, 7.24, 4.26, 10.84, 4.82, 5.68]),
    "II":  (x,  [9.14, 8.14, 8.74, 8.77, 9.26, 8.10, 6.13, 3.10, 9.13, 7.26, 4.74]),
    "III": (x,  [7.46, 6.77, 12.74, 7.11, 7.81, 8.84, 6.08, 5.39, 8.15, 6.42, 5.73]),
    "IV":  (x4, [6.58, 5.76, 7.71, 8.84, 8.47, 7.04, 5.25, 12.50, 5.56, 7.91, 6.89]),
}
for name, (xs, y) in ys.items():
    slope, intercept = linear_regression(xs, y)
    print(f"{name:>3}: x平均={mean(xs):.1f} y平均={mean(y):.2f} "
          f"y分散={variance(y):.2f} 相関={correlation(xs, y):.3f} "
          f"回帰 y={intercept:.2f}+{slope:.3f}x")
Python 3.12で実行した出力は次のとおりです。表示した桁数では、4組ともyの平均7.50・相関0.816〜0.817・回帰直線 y=3.00+0.500x に揃います。
  I: x平均=9.0 y平均=7.50 y分散=4.13 相関=0.816 回帰 y=3.00+0.500x
 II: x平均=9.0 y平均=7.50 y分散=4.13 相関=0.816 回帰 y=3.00+0.500x
III: x平均=9.0 y平均=7.50 y分散=4.12 相関=0.816 回帰 y=3.00+0.500x
 IV: x平均=9.0 y平均=7.50 y分散=4.12 相関=0.817 回帰 y=3.00+0.500x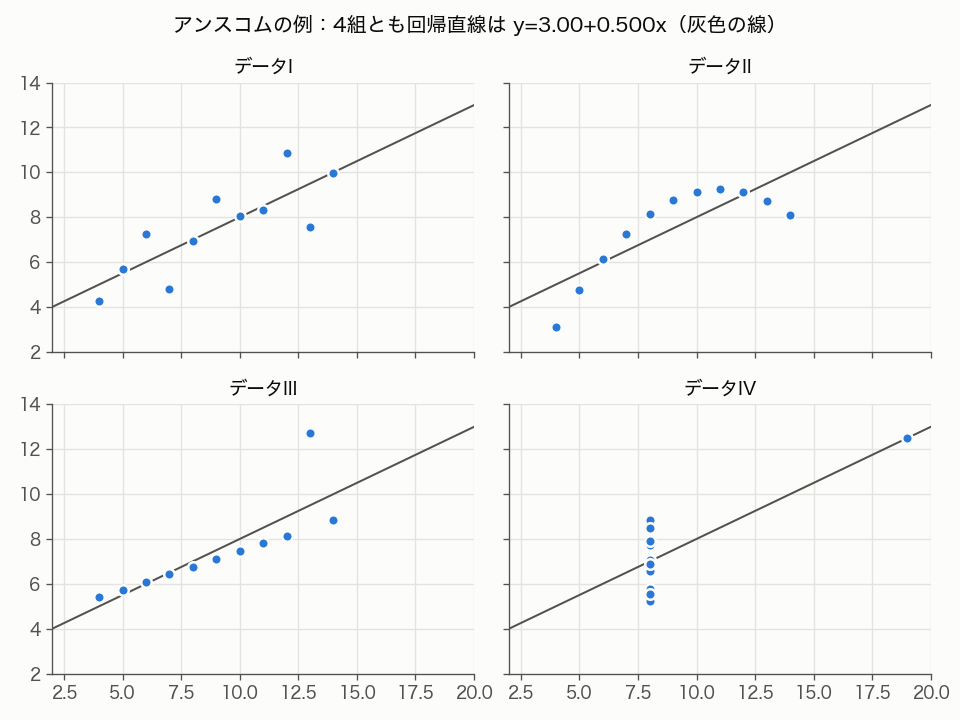
同じ目盛りで散布図にすると、4組の形の違いはひと目でわかります。要約統計だけを報告書に載せると、この4組は「同じデータ」として扱われます。集計の前に散布図やヒストグラムで形を確かめる工程を飛ばさないことが、可視化の最初の実用的な効果です。統計量の計算方法はPython statisticsモジュールの使い方|平均・中央値・分散・標準偏差とNumPyとの違いで解説しています。
人がグラフを正確に読める順番
ウィリアム・クリーブランドとロバート・マギルは1984年の論文「Graphical Perception」(Journal of the American Statistical Association)で、グラフから数量を読み取るときの基本的な知覚の作業を10種類に分け、読み取りの正確さで次のように順位付けする仮説を立てました(同じ順位に複数の作業が入る段は、論文でも区別できていないとしています)。
- 共通の目盛り上の位置(揃った軸の上の棒の先端・点)
- 揃っていない目盛り上の位置
- 長さ・方向・角度
- 面積
- 体積・曲率
- 色の濃淡・彩度
このうち実験で確かめられたのは、位置と長さ、位置と角度の比較です。被験者にグラフ上の2つの値の比を判断させたところ(各実験51人分を分析)、共通の目盛り上の位置による判断は、長さによる判断より1.4〜2.5倍、円グラフの角度による判断より1.96倍正確でした。面積・体積・色の濃淡の順位は、心理物理学の理論と先行実験をもとにした仮説の段階です。
比較の正確さが問われる場面で円グラフより棒グラフや点グラフを選ぶ判断は、この実験で裏付けられます。面積や色の濃淡は仮説上の順位が低いので、おおまかな傾向を示す用途に限るのが無難です。
データビジュアライゼーションの作り方:5つの手順
ツールが何であっても、作業の順番は同じです。グラフの形を選ぶのは3番目で、その前の2つを飛ばすと、きれいでも何も決められないグラフになります。
- 問いを1文で書く:「誰が、何を決めるために見るか」を書きます。「営業部長が、来期に人員を増やす地域を決める」まで書ければ、比べるべきもの(地域ごとの受注の伸び)が決まります。
- データを確かめる:指標の定義、単位、期間、欠損の有無を確かめ、要約統計だけでなく分布を一度描きます。前の章のアンスコムの例のように、平均が同じでも形が違うことがあるためです。
- 比べさせたいことから形を選ぶ:比較・推移・割合・分布・関係・流れのどれを見せるかで決めます(次の章の表)。
- 強調を1つに絞る:軸の起点は値の比較を歪めないように設定し、系列名の直書きや1系列だけへの強調色で、読み手が最初に注目する対象を明確にします。
- 第三者に読ませて確かめる:作った人以外に「このグラフから何が言えるか」を答えてもらい、手順1の問いへの答えと違えば、形か強調を直します。
目的別のグラフの選び方
グラフは、データの形ではなく「読み手に何を比べさせたいか」で選びます。
| 見せたいこと | 基本の形 | 避けたい形 |
|---|---|---|
| 項目間の大小 | 棒グラフ(横棒・縦棒) | 3D棒・円グラフ |
| 時間の推移 | 折れ線グラフ | 項目が多い棒の並び |
| 全体に占める割合 | 100%積み上げ棒・少数項目の円 | 項目が多い・割合が近い円グラフ |
| 値のばらつき・分布 | ヒストグラム・箱ひげ図 | 平均値だけの棒 |
| 2つの変数の関係 | 散布図 | 二軸の折れ線 |
| 地域ごとの差 | 塗り分け地図・点の地図 | 面積の大きい地域が目立つだけの地図 |
| 上位の少数が占める割合 | パレート図 | 項目順の棒グラフ |
| 増減の内訳 | ウォーターフォール図 | 前後2本だけの棒 |
| 量の流れ・移動 | サンキー図 | 区間ごとに分けた円グラフ |
| 階層の構成 | ツリーマップ | 入れ子の円グラフ |
| 2つの分類の組み合わせ | ヒートマップ | 系列が多い棒グラフ |
下の5行は、基本の形では表しにくい問いに使う応用の形です。面積や色の濃淡で値を表す部分があるものは、元の数値をラベルで併記します。パレート図の作り方はパレート図とは?エクセルでの作り方と読み方、ABC分析との関係を解説で扱っています。
棒グラフで守る3つの規則
棒グラフは棒の長さで値を表すため、縦軸(値の軸)は0から始めます。途中から始めると、長さの比が値の比と一致しなくなります(次の章で数値を示します)。値の差だけを強調したいなら、0起点でなくてもよい点グラフや折れ線グラフ、あるいは差そのものの棒を使います。
項目に自然な順序(年・月・年齢層など)がないときは、値の大きい順に並べます。50音順やシステム上のID順に並べると、読み手は最大・最小を探すために全部の棒を見比べることになります。
項目名が長いとき、項目数が多いときは横棒グラフにします。縦棒で長いラベルを斜めに傾けると読みにくく、横棒なら項目名を左に横書きで並べられます。
円グラフを使ってよい場面と避ける場面
円グラフは角度と面積で割合を表すため、読み取りが不正確な部類に入ります。使うのは、項目が2〜3個で「一方が半分を超えるか」のような大まかな割合を示す場面に限ります(項目数は実験で決まった上限ではなく、この記事の目安です)。項目が多い、似た大きさの項目を比べたい、複数の年を比べたい、のいずれかに当てはまるなら、100%積み上げ棒グラフや並べた棒グラフに置き換えます。
誤解を招くグラフの典型パターン
意図的でなくても、描き方ひとつで読み手の受け取る差は大きく変わります。次のコードは、102と108という2つの値を、縦軸0起点と100起点の棒グラフで描き、見た目の長さの比を計算します(matplotlib 3.9.4で実行)。
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

labels = ["A", "B"]
values = [102, 108]

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(8, 3))
ax1.bar(labels, values)
ax1.set_ylim(0, 120)
ax1.set_title("ylim 0-120")
ax2.bar(labels, values)
ax2.set_ylim(100, 110)
ax2.set_title("ylim 100-110")
fig.savefig("axis_demo.png", dpi=100)

# 棒の見た目の長さの比(描画領域の下端から測る)
for ax in (ax1, ax2):
    bottom, top = ax.get_ylim()
    ratio = (values[1] - bottom) / (values[0] - bottom)
    print(f"下端{bottom:g}: 見た目の比 {ratio:.2f}倍")
print(f"実際の比 {values[1] / values[0]:.2f}倍")
下端0: 見た目の比 1.06倍
下端100: 見た目の比 4.00倍
実際の比 1.06倍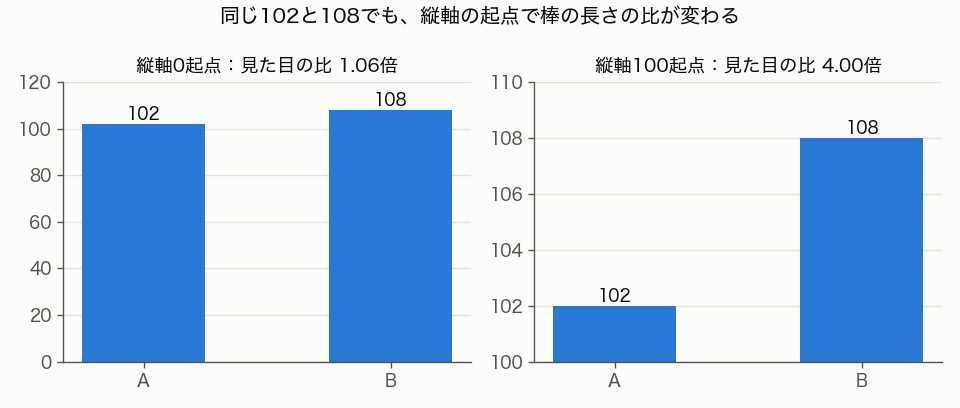
実際には約6%の差なのに、100起点の棒グラフでは棒の長さが4倍に見えます。ほかにも、次の描き方は読み手の判断を誤らせやすい典型です。
- 二軸グラフ:左右の目盛りを自由に決められるため、2本の線が交差する位置や傾きの印象を作り手が操作できます。2つの指標の関係を示したいなら散布図、推移を並べたいなら上下に分けた2枚のグラフにします。
- 3D表示:奥行きの遠近で手前の要素が大きく見え、棒の先端がどの目盛りに当たるかも読みにくくなります。3D円グラフでは、手前の扇形が実際の割合より大きく見えます。タフテは1983年の著書で、図に使うインクのうちデータを表す部分の割合(データインク比)を高めるよう説いており、奥行きや影はデータを表さないインクの典型です。
- アイコンの大きさで数量を表す:値が2倍のときにアイコンの縦横を2倍にすると、面積は4倍になります。アイコンを使うなら、大きさでなく個数で表します。
- 期間の切り取り:折れ線グラフの開始時点を、都合のよい底や天井に合わせると、傾向の印象が逆転します。比較の起点を変えた理由を注記するか、長い期間も併せて示します。
色の使い方と色覚の多様性への配慮
日本眼科医会によると、日本人の先天赤緑色覚異常の頻度は男性で5%(20人に1人)、女性で0.2%(500人に1人)です。見分けにくい色の組み合わせは人によって違いますが、「赤は未達・緑は達成」のように赤と緑だけで意味を分ける配色は、読み手の一部に意味が伝わらないおそれがあります。
Webで公開するグラフには、W3CのWebアクセシビリティ基準 WCAG 2.2 の2つの達成基準が関係します。達成基準1.4.1「色の使用」は、色を情報を伝える唯一の手段にしないことを求めます。達成基準1.4.11「非テキストのコントラスト」は、グラフの線や棒のように内容の理解に必要な図形について、隣接する色とのコントラスト比を3:1以上にすることを求めます。具体的な計算方法とCSSでの実装はWebアクセシビリティのコントラスト比:4.5対1と3対1の適用範囲・CSS実装・自動検証の落とし穴で扱っています。
設計の出発点として、次の3つを押さえます。凡例を離れた場所に置かず、線や棒の横に系列名を直接書く。強調したい1系列だけに色を付け、ほかは灰色にする。連続値の色分けには、明るさが一方向に変わる配色(matplotlibが2.0から既定にした viridis など)を使い、虹色の配色は避ける。
AIとデータビジュアライゼーション:グラフを作らせる場合と結果を見せる場合
AIにグラフを作らせるときの確認点
BIツールには、自然言語の指示からグラフを作る機能が入っています。たとえばMicrosoftのPower BIのCopilotは、自然言語のプロンプトでレポートページを作成・編集でき、既存のページにビジュアルを追加することもできます。各BIツールのAI機能の違いはBIツールのAI機能とは?自然言語クエリ・予測分析の実力と導入判断まで解説で比べています。
AIはグラフの作成に加えて、表示する内容の提案も支援します。ただし、業務上の問い(手順1)や指標の定義とデータの妥当性(手順2)は、人の責任で確かめます。生成されたグラフは、少なくとも次の3点を確かめてから共有します。
- 集計の定義:「売上」が受注か請求か、合計か平均か
- グラフの種類と縦軸の起点:棒グラフが0起点か、比較に円グラフが選ばれていないか
- 期間とフィルター:意図しない期間の切り取りや除外条件が入っていないか
AIの分析結果を見せる:ワードクラウドと2次元マップ
アンケートの自由回答のようなテキストの分析結果は、頻出語の大きさで示すワードクラウドや、一緒に出てくる語を線で結ぶ共起ネットワークで見せるのが一般的です。手法と無料ツールはテキストマイニングとは?手法・やり方・無料ツールから企業の導入判断まで解説で扱っています。ワードクラウドは頻度や順位に応じて文字サイズを変えますが、文字数や配置条件も見た目に影響し、面積が頻度に比例するとは限らないため、順位や正確な差を伝える用途には向かず、頻度は棒グラフで並べ直して示します。
文章や画像をAIで数値のベクトル(埋め込み)に変えると、数百次元のデータになります。これを2次元の散布図に落とす代表的な手法が、ファン・デル・マーテンとヒントンが2008年にJournal of Machine Learning Research第9巻で発表したt-SNEです。ただし、2016年10月13日公開のDistillの解説「How to Use t-SNE Effectively」は、t-SNEの図のクラスタの大きさは元データの広がりを表さず(Cluster sizes in a t-SNE plot mean nothing)、クラスタ間の距離も意味を持たない場合がある(Distances between clusters might not mean anything)と注意しています。
そのため、t-SNEの図を見て「この2つの顧客群は近い」「このグループは大きい」と報告するのは避けます。図は群構造の仮説を立てる入口に使います。ランダムなデータにも塊が現れることがあるため、群の存在自体と、群どうしの近さや広がりを元の次元のデータで検証します。perplexityの決め方と実装はt-SNEとは?仕組みとperplexityの決め方、Python(scikit-learn)での2D・3D可視化で解説しています。
データビジュアライゼーションのツールの選び分け
ツールは「誰が、どのくらいの頻度で、どこから来たデータを見るか」と、「表現をどこまで作り込みたいか」で選びます。1回限りの報告ならExcelやGoogleスプレッドシートで足り、毎週同じ指標を複数人で見るならBIツール、独自の表現や自動生成が必要ならプログラミングのライブラリ、という分け方が出発点になります。
| 分類 | 代表例 | 向いている用途 |
|---|---|---|
| 表計算 | Excel・Googleスプレッドシート | 単発の集計と報告 |
| BIツール(有償中心) | Power BI・Tableau | 社内の定例レポート・ダッシュボード |
| BIツール(無料・OSS) | Data Studio(旧Looker Studio)・Metabase | GA4やDBの指標を共有 |
| ライブラリ(Python) | matplotlib・Bokeh | 分析の図・自動生成 |
| ライブラリ(JavaScript) | D3.js・ECharts | Webページへの埋め込み・独自の表現 |
可視化の手軽さとカスタマイズ性は両立しにくく、どちらを優先するかで選びます。BIツールは標準のグラフと設定項目の範囲なら速く作れますが、その外側の表現は、Power BIのカスタムビジュアルのような拡張機能を開発するか、表現をあきらめることになります。ライブラリは表現の自由度が高い代わりに、データの取り込みや更新の仕組みも自分で作ります。定例の指標はBIツール、Webサービスに組み込む図や独自の表現はライブラリ、と用途で分けます。
製品ごとの機能と料金は個別記事で扱っています。Microsoft環境が中心ならPower BIとは?できること・料金・Excelやtableauとの違いから導入判断まで解説、Tableauの操作はTableauの使い方|基本操作・ダッシュボード作成とショートカット一覧【2026.3対応】をご覧ください。Looker Studioは2026年4月16日にData Studioへ改称されました。無料でできる範囲はLooker Studio(データポータル)とは?無料でできる範囲・Pro料金と制限値、Lookerとの違い、OSSで社内DBに直接つなぐならMetabaseの料金と使い方|無料OSS版と有料プランの価格差・商用利用とライセンスの範囲【2026年版】で解説しています。社内のデータ基盤とあわせてBIツールを選び、ダッシュボードまで作る場合は、BIツール導入支援でご相談を受けています。
コードで描く場合、Pythonでは静的な図に強いmatplotlib(2026年11月4日確認時点の最新安定版は、2026年9月11日公開の3.11.2)が標準的で、ブラウザで操作できる図にはBokehとは?Pythonでの使い方と2軸グラフの作り方【3.10.1対応】が選択肢になります。JavaScriptでは、D3.jsで独自の図を組む例をバブルチャートとは?D3.js v7での作り方(Pack Layout・散布図型)とExcelの手順で、用意された種類で大量データを描く方法をEChartsとは?6.1系の部分インポートと大量データの描画設定・Chart.jsとの選び分けで紹介しています。
可視化より先に整えるべき場面
グラフを作る前に止めたほうがよい場面もあります。指標の定義が部署ごとに違う(「売上」が受注ベースか請求ベースか決まっていない)状態でダッシュボードを作ると、グラフが出るたびに数字の食い違いの議論が始まり、可視化が意思決定を遅らせます。この場合は、可視化より先に指標の定義書を作ります。
伝えたいことが1つの数値で足りるときも、グラフは不要です。「前年比106%」と1文で書くほうが、棒グラフ1枚より早く正確に伝わります。
よくある質問
データビジュアライゼーションとはどういう意味ですか?
数値やテキストのデータを、位置・長さ・色などの視覚要素に置き換えて、比較・推移・分布・関係を読み取れるようにすることです。日本語の「データ可視化」とほぼ同じ意味で使われます。
データビジュアライゼーションにはどんな種類がありますか?
目的で分けると、項目間の比較(棒グラフ)、時間の推移(折れ線グラフ)、割合(積み上げ棒・円グラフ)、分布(ヒストグラム・箱ひげ図)、関係(散布図)、地理(地図)、流れ(サンキー図)が基本です。分野で分けると、CT画像などの科学技術の可視化と、統計や業務データの情報の可視化があります。
ビジュアライゼーションとは何ですか?
英語の visualization(視覚化)をカタカナにした言葉で、データのグラフ化に限らず、建築の完成予想図(建築ビジュアライゼーション)や医療画像の3D表示なども含みます。ビジネスでデータのグラフ化を指すときは「データビジュアライゼーション」と言うのが一般的です。
ビジュアライゼーションのやり方は?
問いを1文で書く、データの定義と分布を確かめる、比べさせたいことからグラフの形を選ぶ、強調を1つに絞る、第三者に読ませて確かめる、の5つの手順で進めます。グラフの形を選ぶのは3番目です。
棒グラフと折れ線グラフはどう使い分けますか?
項目同士の大小を比べるなら棒グラフ、時間に沿った変化を見せるなら折れ線グラフです。棒グラフは縦軸を0から始める必要がありますが、折れ線グラフは変化の形を見せるものなので0以外から始めても構いません。その場合も、目盛りの数値を表示し、起点を変えたことが読み手にわかるようにします。