デンドログラムは、階層的クラスタリングがデータをどの順番で、どれだけ離れた状態でまとめていったかを枝分かれで表した図です。この記事では「どこで横線を引けば、いくつのグループになるのか」を中心に、縦軸の高さの意味、クラスタ数を決める手順、標準化やリンケージ手法の選び方、PythonのSciPyとRでの作り方までを、実行結果と公式ドキュメントの記述をもとに整理します。
まとめ:デンドログラムの読み方とクラスタ数の決め方の要点
- 縦軸(高さ)はクラスタ同士の距離です。低い位置で合流した枝ほど似ています。
- 横方向の並び順に意味はありません。隣り合っているだけでは似ている根拠になりません。
- クラスタ数は「合流の高さが大きく跳ねる直前」で横線を引いて決めます。跳ね幅の大きい区間なら、しきい値が多少ぶれても結果は同じです。
- 図の実体は連結行列(linkage matrix)です。高さの差分を取れば、クラスタ数の候補をコードで出せます。
- 単位やばらつきの違う変数は標準化を検討します。本文の購入額(円)と来店回数の例では、生データのままだと購入額の差が距離を支配し、来店回数の違いが分類に効きませんでした。
- SciPyの
fcluster(Z, t=3)は「3クラスタ」の意味になりません。既定の基準が inconsistent なので、クラスタ数で切るときはcriterion="maxclust"を明示します。 - ウォード法・重心法・メディアン法はユークリッド距離が前提です。Rでウォード法を使うなら ward.D2 を指定します。
- 倍精度の圧縮距離配列は件数の2乗で増え、5万件で約10GBです。作業領域を含めてメモリか時間が足りないときは、k-meansや二段構えに切り替えます。
デンドログラムとは:階層的クラスタリングの統合過程を記録した樹形図
デンドログラムは、階層的クラスタリング(階層型クラスター分析)の出力を可視化した図です。個々のデータ点が葉として下端に並び、似ているもの同士が結合していく様子が上へ伸びる枝で描かれ、最後に1本の根にまとまります。回帰や主成分分析など他の多変量の手法との位置づけは多変量解析とは?予測と要約で選ぶ手法一覧とビジネスでの使いどころで整理しています。
押さえておきたいのは、デンドログラムが「答え」ではなく「過程の記録」だという点です。k-meansが返すのは各点の所属とクラスタ中心で、どの順にまとまったかという履歴は残りません。デンドログラムには、どのデータがどの段階で、どの距離で結合したかがすべて残ります。クラスタ数を後から選び直せるのはこのためです。
dendro(デンドロ)の意味と語源:古代ギリシャ語の「木」に由来
dendrogram は dendro- と -gram の合成語です。dendro- は古代ギリシャ語で「木」を表す dendron に、-gram は「書かれたもの・記録」を表す語根にさかのぼります。直訳すると「木の図」で、日本語では「樹形図」と訳されます。dendro- は「木」を意味する接頭辞として、樹木学(dendrology)や樹状突起(dendrite)にも使われています。なお、検索結果に多く並ぶ『インフィニット・デンドログラム』はライトノベル・アニメ作品の名前で、この記事の分析手法とは関係ありません。
数学の樹形図・ロジックツリー・決定木との違い
日本語で「樹形図」と呼ばれる図は複数あります。デンドログラムだけが、データ間の距離を縦軸の高さで表します。中学数学の樹形図は起こりうる場合を枝で数え上げる図で、距離の概念はありません(樹形図とは?書き方の手順と例題で学ぶ場合の数・確率)。ロジックツリーの例題と解答|残業・売上減少・工数削減で学ぶ作り方は人が論理で切り分けた枝で、データから計算した枝ではありません。決定木分析とは?分類木・回帰木の仕組みと過学習を防ぐ剪定・アンサンブルを実装目線で解説で扱う決定木は、正解ラベルを使って分岐条件を学ぶ教師あり学習です。ラベルを使わずに似たもの同士をまとめるデンドログラムとは目的が違います。
デンドログラムの見方:縦軸の高さ・合流点・葉の並び順が示す意味
読む順番は、縦軸の目盛りと距離尺度を確認する、枝が合流する高さを下から追う、高さが大きく跳ねる箇所を探す、の順です。
縦軸の高さはクラスタ間の距離で、低い合流ほど似たもの同士
縦軸はクラスタ同士の非類似度、つまり距離です。2つの枝が低い位置で合流していれば、互いに近いデータでした。高い位置での合流は、離れたもの同士を統合した段階を表します。目盛りの意味は距離尺度で変わり、ユークリッド距離なら元データと同じ単位、相関距離なら0から2の範囲です。
葉の左右の並び順と合流点の高さの区別
葉の左右の並びと合流点の高さは区別して読みます。葉の並びは描画時の設定で変わるため、隣接していることだけでは類似性を判断できません。SciPyの linkage に optimal_ordering=True を渡すと隣り合う葉同士の距離が小さくなるよう並べ替えますが、それでも所属を決めるのは合流点の高さです。下の図ではHとFが隣り合っていますが、2つが合流するのは高さ8.307で、AとCが合流する0.283の約29倍です。左端と右端のデータが、上の段で同じクラスタになることもあります。
連結行列の4列とデンドログラムの対応
図の背後には連結行列と呼ばれる数表があります。SciPyのscipy.cluster.hierarchy.linkageがこの行列を返します。3つのかたまりを想定した8点の2次元データに、ウォード法を適用した例です。
import numpy as np
from scipy.cluster.hierarchy import linkage, dendrogram
import matplotlib.pyplot as plt

# 8点の2次元データ(3つのかたまりを想定)
data = np.array([
    [1.0, 2.1], [1.2, 1.9], [0.8, 2.3],
    [5.4, 5.2], [5.1, 5.0], [5.6, 4.8],
    [9.0, 1.0], [9.3, 1.4],
])
labels = ["A", "B", "C", "D", "E", "F", "G", "H"]
Z = linkage(data, method="ward")
print(np.round(Z, 3))
SciPy 1.18.1での出力です。
[[ 0.     2.     0.283  2.   ]
 [ 3.     4.     0.361  2.   ]
 [ 1.     8.     0.49   3.   ]
 [ 6.     7.     0.5    2.   ]
 [ 5.     9.     0.532  3.   ]
 [11.    12.     8.307  5.   ]
 [10.    13.    11.696  8.   ]]
各行が1回の結合で、左から「結合した要素1」「結合した要素2」「そのときの距離=図の高さ」「できたクラスタの点数」です。0から7は元データのA〜H、8以降は新しくできたクラスタに順に振られる番号です。1行目はAとC(0と2)が距離0.283で結合してクラスタ8になったこと、3行目はBとクラスタ8が結合してA・B・Cの3点(クラスタ10)になったことを示します。デンドログラムはこの7行を図に起こしたもので、目で読める情報はすべてここにあります。この連結行列を描いたのが次の図です。
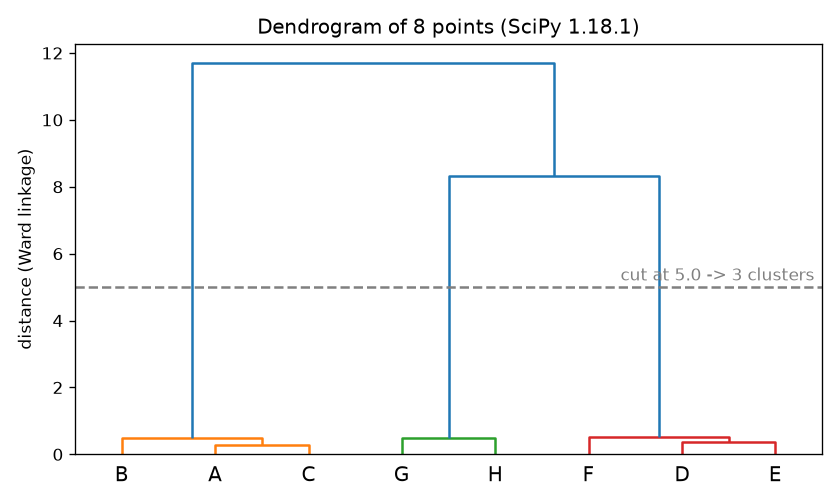
図:8点のデータにウォード法をかけたデンドログラム(SciPy 1.18.1で作成)。破線は高さ5.0の切断線で、A・B・C、G・H、D・E・Fの3つに色分けされています。
合流点の高さが大きく跳ねる箇所がクラスタの切れ目になる理由
距離の列を上から追うと、0.283、0.361、0.49、0.5、0.532と小さな値が続き、6行目で8.307へ跳ね上がります。約15.6倍です。このジャンプは、選んだ距離尺度とリンケージ手法の下で、離れたかたまり同士を統合したことを示し、分割数を選ぶ目安になります。クラスタ数は跳ねる直前の3が妥当で、横線は0.532と8.307の間に引きます。エルボー法でいう「曲がり角」を、デンドログラムでは合流点の高さの並びから直接読んでいるわけです。
5点の1次元データによる最短距離法・最長距離法の手計算
図の作られ方を手で確かめておくと、読み違いが減ります。1次元の5点 P1=1、P2=2、P3=4、P4=7、P5=8.5 を使います。凝集型は「いまあるクラスタの中で一番近い2つをまとめる」を全体が1つになるまで繰り返し、手法の違いは「まとめた後のクラスタと他との距離をどう測るか」だけです。
| 回 | 統合した組 | 最短距離法の高さ | 最長距離法の高さ |
|---|---|---|---|
| 1 | P1 と P2 | 1 | 1 |
| 2 | P4 と P5 | 1.5 | 1.5 |
| 3 | P1P2 と P3 | 2 | 3 |
| 4 | P1P2P3 と P4P5 | 3 | 7.5 |
差が出るのは3回目です。最短距離法は {P1,P2} と P3 の距離を一番近いペアの P2-P3=2 で、最長距離法は一番遠いペアの P1-P3=3 で測ります。最後の統合でも、最短距離法は P3-P4=3、最長距離法は P1-P5=7.5 を採ります。最短距離法の高さは1、1.5、2、3となだらかで切れ目が見えません。最長距離法は3から7.5へ跳ねるため「{P1,P2,P3} と {P4,P5} の2つ」と読めます。群平均法なら最後の高さは6ペアの平均の約5.417で、両者の中間です。同じデータでも、手法の定義で切れ目の見え方が変わります。
階層的クラスタリングの仕組み:距離尺度・前処理・リンケージ手法
分析者が決めるのは距離尺度とリンケージ手法の2つ
階層的クラスタリングには、1点ずつを別々のクラスタとして始めて併合していく凝集型(ボトムアップ)と、全体を1つとして始めて分割していく分割型(トップダウン)があります。SciPyやRの標準実装、実務で目にするデンドログラムのほとんどは凝集型です。
凝集型で分析者が決めるのは、データ点同士の距離をどう測るか(距離尺度)と、クラスタとクラスタの距離をどう定義するか(リンケージ手法)の2つです。距離尺度は、数値の大きさそのものを比べたいならユークリッド距離、外れ値の影響を抑えたいならマンハッタン距離、文書ベクトルのように向きだけを比べたいならコサイン距離を選びます(考え方はコサイン類似度とは?計算式・仕組みと類似検索での実装を実装目線で解説)。
購入額と来店回数の例で見る標準化の効果
ユークリッド距離では各変数の差を2乗して足し合わせるため、観測値間の差が大きい変数ほど距離への寄与が大きくなります。値そのものの桁より、変数ごとのばらつきに注意が必要です。年間購入額(円)と来店回数(回)を持つ8人の顧客で、標準化の有無を比べました。購入額は12万円前後と30万円前後の2群、来店回数は2〜4回と24〜27回の2群に分かれるように作っています。
import numpy as np
from scipy.cluster.hierarchy import linkage, fcluster
from scipy.stats import zscore

# 8人の顧客:年間購入額(円)と来店回数(回)
X = np.array([
    [120000, 2], [125000, 3], [118000, 25], [122000, 27],
    [300000, 4], [305000, 26], [298000, 3], [302000, 24],
], dtype=float)

for name, M in [("生データ", X), ("標準化", zscore(X, axis=0))]:
    L = linkage(M, method="ward")
    print(name, fcluster(L, t=4, criterion="maxclust"), np.round(L[:, 2], 2))
生データ [1 2 1 2 3 4 3 4] [ 2000. 2000.13 3000. 3000.1 6363.96 6364.03 360000. ]
標準化 [3 3 4 4 1 2 1 2] [0.09 0.1 0.18 0.18 2.69 2.94 4. ]生データのまま4つに切ると、1人目(2回)と3人目(25回)が同じクラスタに入ります。合流の高さが2,000や3,000という数値で、購入額の数千円の差だけで結合が決まり、来店回数の20回以上の差は距離にほとんど効いていません。標準化(各変数を平均0・標準偏差1にそろえる)すると、「12万円・来店少」「12万円・来店多」「30万円・来店少」「30万円・来店多」の4群に正しく分かれました。単位の違う変数を使うときは、標準化してから距離を測ってください。逆に、すべての変数が同じ単位で、桁の差そのものに意味がある場合(同じ単位で測った売上の構成比など)は標準化しないという判断もあります。
SciPyのlinkageが受け付けるリンケージ手法7種と前提条件
SciPyの linkage が受け付ける method は次の7種類です。
| method | 和名・別名 | クラスタ間距離の定義 | ユークリッド距離が前提 |
|---|---|---|---|
| single | 最短距離法 | 全ペアの最小値 | 不要 |
| complete | 最長距離法 | 全ペアの最大値 | 不要 |
| average | 群平均法・UPGMA | 全ペアの平均 | 不要 |
| weighted | WPGMA | 直前に統合した2つの距離の平均 | 不要 |
| centroid | 重心法・UPGMC | 重心同士の距離 | 必要 |
| median | メディアン法・WPGMC | 代表点間の距離(統合後は2点の中点) | 必要 |
| ward | ウォード法 | 統合による平方和増加量の2倍の平方根 | 必要 |
ウォード法は、統合したときにクラスタ内の平方和がもっとも増えない組み合わせを選ぶ手法です。原典は Ward, Joe H. (1963)「Hierarchical Grouping to Optimize an Objective Function」(Journal of the American Statistical Association 58巻301号 236-244頁)。最短距離法は鎖状につながったクラスタを拾える反面、細長い連鎖を1つにまとめてしまいます。手計算で最短距離法の高さがなだらかだったのはこの性質の表れです。最長距離法はまとまりの良い塊を作りやすい代わりに、大きなクラスタを分断しやすくなります。
表の「必要」の3手法には明確な制約があります。SciPyのlinkageのドキュメントは Methods 'centroid', 'median', and 'ward' are correctly defined only if Euclidean pairwise metric is used. と述べ、距離行列を渡す場合も、それがユークリッド距離であることの保証は利用者の責任だとしています。SciPyはコサイン距離の行列にウォード法をかけてもエラーを出さず、誤った結果を返します。一方scikit-learnのAgglomerativeClusteringは、linkage が ward のとき metric に euclidean か l2 以外を指定するとエラーで止めます。コサイン距離を使いたいなら、群平均法か最長距離法を組み合わせるか、ベクトルを長さ1に正規化してからユークリッド距離でウォード法をかけます。
リンケージ手法を変えると統合順序が入れ替わる実測例
手法の選択は図の見た目の話ではなく、まとめる順番の話です。先ほどの8点で、最後の2回の結合を4手法で比べました(SciPy 1.18.1)。A・B・Cが左下、D・E・Fが中央上、G・Hが右下の塊です。
| method | 6回目の結合 | 高さ | 7回目の結合 | 高さ |
|---|---|---|---|---|
| single | ABC と DEF | 4.982 | GH と ABCDEF | 5.025 |
| complete | DEF と ABC | 5.438 | GH と ABCDEF | 8.548 |
| average | ABC と DEF | 5.251 | GH と ABCDEF | 6.787 |
| ward | GH と DEF | 8.307 | ABC と DEFGH | 11.696 |
ウォード法だけが違う組み合わせを先に結合しています。重心間の距離はABC-DEFが5.242、DEF-GHが5.362で、重心だけならABCとDEFのほうが近い組です。ところがウォード法の連結距離は、重心間距離に「2つの点数の積の2倍を点数の和で割った値の平方根」を掛けたもので、この係数は3点と3点なら1.732、3点と2点なら1.549です。結果はABC-DEFが5.242×1.732=9.079、DEF-GHが5.362×1.549=8.307となり、重心の近さとは逆の順で統合されます。大きいクラスタ同士の統合に強いペナルティがかかるため、ウォード法はサイズのそろったクラスタを作りやすくなります。図の形が想定と違うときは、データを疑う前に手法の性質を確認してください。
クラスタ数の決め方:高さのジャンプ・fcluster・コーフェン相関で絞る手順
手順は、高さのジャンプで候補を出す、fclusterで所属ラベルを確定する、コーフェン相関で図の距離再現度を確認する、内部評価指標で各候補の分け方を確かめる、の順です。
fclusterで所属ラベルを確定する:既定のinconsistentに注意
目視で横線を引く代わりに、SciPyのfclusterで所属ラベルを取り出せます。criterion は inconsistent、distance、maxclust、monocrit、maxclust_monocrit の5種類で、既定は inconsistent です。クラスタ数を指定したつもりで criterion を省くと、次のように意図しない結果になります。
from scipy.cluster.hierarchy import fcluster

print(fcluster(Z, t=3))                        # criterion省略=inconsistent
print(fcluster(Z, t=3, criterion="maxclust"))   # クラスタ数3
print(fcluster(Z, t=5.0, criterion="distance")) # 高さ5.0で切る
print(fcluster(Z, t=0.6, criterion="distance")) # 高さ0.6で切る
[1 1 1 1 1 1 1 1]
[1 1 1 3 3 3 2 2]
[1 1 1 3 3 3 2 2]
[1 1 1 3 3 3 2 2]1行目は8点すべてが1つのクラスタです。inconsistent は「各結合の高さが、自身とその下の結合(既定は2段)の高さの平均から標準偏差いくつ分離れているか」(不整合係数)をしきい値tと比べる基準で、t=3は「3クラスタ」ではなく「不整合係数3」を意味します。クラスタ数で切るなら maxclust、高さで切るなら distance を明示してください。maxclust の t はクラスタ数の上限で、同じ高さの結合があると指定数より少なく分かれる場合があります。
2〜4行目はA・B・Cが1、D・E・Fが3、G・Hが2です。番号は左からの順番と一致しないので、番号の若さに意味を読まないでください。しきい値を0.6にしても5.0にしても結果が同じなのは、0.532と8.307の間ならどこで切っても3クラスタになるからです。逆に、しきい値を少し動かすだけでクラスタ数が変わるなら、その高さ付近では分割が安定していません。別の高さや距離尺度でも確かめてください。
合流点の高さの差分によるクラスタ数候補の算出
この8点のウォード法の例では、連結行列の3列目(高さ)の隣同士の差を取り、差が最大の位置の直前を切断候補にできます。このコードは3点以上で、高さが単調に増える連結行列を前提とします。n点のデータで i+1 回の結合を終えた時点のクラスタ数は n-(i+1) です。
heights = Z[:, 2]
gaps = np.diff(heights)
i = int(np.argmax(gaps))
k = len(heights) + 1 - (i + 1)
print("候補のクラスタ数:", k)
print(fcluster(Z, t=k, criterion="maxclust"))
候補のクラスタ数: 3
[1 1 1 3 3 3 2 2]この8点では、5回目から6回目への約7.78(0.532から8.307)が最大の差です。実データでは差が2番目、3番目に大きい位置も候補に加え、2〜5程度の候補を出してから次の指標で比べます。最後の結合の差が最大なら、まず2クラスタが候補です。次点の差に対応する分割も並べ、業務上の目的に照らして比べます。
コーフェン相関係数によるリンケージ手法の距離再現度の比較
ジャンプが曖昧で切りどころが決まらないときは、リンケージ手法そのものを見直します。判断材料はコーフェン相関係数です。元データの距離と、デンドログラム上で読み取れる距離(コーフェン距離)の相関で、1に近いほど図が元の距離関係を忠実に再現しています。SciPyではcophenetで計算します。
from scipy.cluster.hierarchy import cophenet
from scipy.spatial.distance import pdist

d = pdist(data)
for method in ["single", "complete", "average", "ward"]:
    c, _ = cophenet(linkage(data, method=method), d)
    print(f"{method:9s} {c:.4f}")
single 0.9085
complete 0.9248
average 0.9380
ward 0.9122このデータでは群平均法が0.9380で最も高く、ウォード法は0.9122です。ウォード法を既定にする習慣は広く見られますが、距離の再現度では常に一番とは限りません。迷ったら複数手法でコーフェン相関を比べ、高い手法の図で判断すると恣意性を減らせます。ただし測っているのは距離の再現度で、業務上意味のある分け方かどうかは別の問題です。
シルエット係数など内部評価指標による候補の比較
決めたクラスタ数の良し悪しは、正解ラベルを使わずにクラスタ内のまとまりとクラスタ間の離れ具合を同時に見る内部評価指標で確かめます。代表はシルエット係数で、scikit-learnのsilhouette_scoreは-1から1の値を返し、1が最良、0付近はクラスタが重なっている状態です。値は各点の係数の平均です。各点の係数は、同じクラスタの他の点への平均距離をa、最も近い別クラスタの点への平均距離をbとして、bからaを引いた値をaとbの大きいほうで割ったものなので、負なら割り当ての見直しが必要な状態と読みます。クラスタ間分散とクラスタ内分散の比を見るCalinski-Harabasz指数も使えます。指標はジャンプで絞った2〜5程度の候補にだけ当ててください。総当たりで指標だけを見ると、階層構造という情報を捨てることになります。
デンドログラムの作り方:Python(SciPy・scikit-learn)とRの描画コード
SciPyのlinkageとdendrogramで描く最小コード
PythonではSciPyの scipy.cluster.hierarchy で完結します。導入方法やNumPyとの関係はSciPyとは?読み方・使い方・NumPyとの違いをPythonで解説にまとめています。2026年10月19日時点でPyPIの最新はSciPy 1.18.1(Python 3.12以上)です。
import numpy as np
from scipy.cluster.hierarchy import linkage, dendrogram
import matplotlib.pyplot as plt

data = np.array([
    [1.0, 2.1], [1.2, 1.9], [0.8, 2.3],
    [5.4, 5.2], [5.1, 5.0], [5.6, 4.8],
    [9.0, 1.0], [9.3, 1.4],
])
labels = ["A", "B", "C", "D", "E", "F", "G", "H"]
Z = linkage(data, method="ward")

plt.figure(figsize=(6, 4))
dendrogram(Z, labels=labels, color_threshold=5.0)
plt.axhline(5.0, linestyle="--", color="gray")
plt.ylabel("distance")
plt.tight_layout()
plt.savefig("dendrogram.png", dpi=120)
linkageで連結行列を作り、dendrogramで描く2段構えです。枝の色分けは color_threshold で決まり、dendrogramのドキュメントによれば、省略時は連結行列の高さの最大値の0.7倍(MATLABの挙動に合わせた値)です。この8点なら11.696×0.7で約8.19となり、たまたま3色に分かれます。既定値は最大の結合高さから機械的に計算され、適切な分割数を選ぶ基準ではないので、fclusterで使ったしきい値を明示して渡し、axhline で切った位置も描き込むと、図とラベルの食い違いを防げます。
件数が多く葉のラベルが潰れるときはtruncate_modeで上位の枝だけ表示
数百件を超えると下端の葉が重なって読めません。truncate_mode には、最後に作られたp個のクラスタだけを残す lastp と、上からp段までを表示する level の2つがあります。
plt.figure(figsize=(6, 4))
dendrogram(
    Z,
    truncate_mode="lastp",
    p=30,
    show_leaf_counts=True,
    show_contracted=True,
)まとめられた葉には、含まれる点数が括弧つきで表示されます。show_contracted=True を付けると、潰れた枝の内部の結合の高さが、その葉につながる枝の上に十字印で描かれます。掲載の8点で試すときは p=3 にすると、括弧付きの点数と十字印を確認できます。全体像は lastp で見て、気になる枝はそのデータだけを取り出して描き直すのが現実的です。
scikit-learnのAgglomerativeClusteringからの連結行列作成と描画
scikit-learn自体には描画関数がないため、公式サンプル(Plot Hierarchical Clustering Dendrogram)と同じ手順で、結合の組・距離・点数からSciPy形式の連結行列を組み立てて dendrogram に渡します。
import numpy as np
from sklearn.cluster import AgglomerativeClustering
from scipy.cluster.hierarchy import dendrogram
import matplotlib.pyplot as plt

model = AgglomerativeClustering(distance_threshold=0, n_clusters=None, linkage="ward")
model.fit(data)

n = len(model.labels_)
counts = np.zeros(model.children_.shape[0])
for i, merge in enumerate(model.children_):
    counts[i] = sum(1 if c < n else counts[c - n] for c in merge)

Z_sk = np.column_stack([model.children_, model.distances_, counts]).astype(float)
plt.figure(figsize=(6, 4))
dendrogram(Z_sk, labels=labels)
plt.tight_layout()
plt.savefig("dendrogram_sklearn.png", dpi=120)
distance_threshold=0 と n_clusters=None の組み合わせで、全段の結合を最後まで計算させるのがポイントです。結合距離の distances_ は、distance_threshold を指定したときか compute_distances=True のときにだけ計算されます。scikit-learn 1.9.1 で実行すると、組み立てた Z_sk はSciPyの linkage で作った連結行列と同じ値になりました。
Rのhclustで描く:ウォード法はward.D2を指定
Rでは標準の hclust を使います。
data <- matrix(c(1.0, 2.1, 1.2, 1.9, 0.8, 2.3,
                 5.4, 5.2, 5.1, 5.0, 5.6, 4.8,
                 9.0, 1.0, 9.3, 1.4), ncol = 2, byrow = TRUE)
hc <- hclust(dist(data), method = "ward.D2")
plot(hc, labels = c("A", "B", "C", "D", "E", "F", "G", "H"))
rect.hclust(hc, k = 3)
cutree(hc, k = 3)
rect.hclust は指定したクラスタ数の枠を図に描き込み、cutree はSciPyのfclusterにあたる所属ラベルを返します。hclustのドキュメントによれば、method には ward.D、ward.D2、single、complete、average(UPGMA)、mcquitty(WPGMA)、median(WPGMC)、centroid(UPGMC)を指定できます。SciPyの weighted はRの mcquitty と同じWPGMAなので、名前だけで対応付けると取り違えます。median と centroid は、合流点の高さが下がる逆転(inversions)が起きて図が読みにくくなる場合があると注意書きがあります。
ward.D は、ドキュメントが does not implement the clustering criterion of Ward Jr. (1963) と明記するとおり、ウォード法の原典の基準を実装していません。原典どおりなのは、距離を2乗してから更新する ward.D2 です。ward.D は、R 3.0.3以前に唯一のウォード指定だった「ward」と等価な選択肢として残されています。古いコードの「ward」をそのまま移植すると、SciPyの method="ward" とは別の結果になるので、RとPythonで結果を突き合わせるときはRを ward.D2 にしてください。
デンドログラムの使い道:顧客セグメント・文書分類・異常の発見
デンドログラムが力を発揮するのは、グループ数を事前に決められない場面です。顧客セグメンテーションでは、購買頻度や単価で顧客を階層的にまとめ、施策として運用できる数まで図の上で統合します。4つにするか6つにするかを切り替えて比べられるのが、クラスタ数を先に指定する手法との違いです(分類軸の置き方は顧客セグメンテーションとは?分類軸・RFM分析・事例でわかる進め方)。テキスト分野では、文書をベクトル化して階層的にまとめることで、想定していなかった話題の塊が見つかります(テキストマイニングとは?手法・やり方・無料ツールから企業の導入判断まで解説)。
品質データやアクセスログでは、正常な塊から離れた高い位置でしか他と結合しない少数のレコードが、異常の候補として浮かびます。ただしデンドログラムは目で探すための道具で、継続的な監視や自動判定には向きません(異常検知とは?機械学習の手法と仕組み・製造業での使いどころと導入判断)。変数が多く距離が意味を失いやすいときは、主成分分析とは?定義・仕組み・分析手順から導入判断まで実装目線で解説で次元を落としてからクラスタリングにかけるか、多次元尺度構成法(MDS)とは?主成分分析との違い・計算手順・活用例を解説で2次元に配置した散布図と併せて読みます。
階層的クラスタリングとk-meansの使い分け:計算量とメモリ量の比較
| 観点 | 階層的クラスタリング | k-means |
|---|---|---|
| クラスタ数 | 図を見て後から決める | 実行前に指定 |
| 出力 | 連結行列とデンドログラム | 所属ラベルと重心 |
| 再現性 | 同条件なら常に同一 | 初期値により変動 |
| 計算量 | SciPyでは手法により2乗〜3乗規模 | データ数に概ね比例 |
| クラスタ形状 | リンケージ次第(鎖状も可) | 球状を仮定 |
分岐点は規模です。SciPyのドキュメントによれば、single は最小全域木、complete・average・weighted・ward は最近傍連鎖法で実装され、時間計算量はいずれもデータ数の2乗のオーダーです。centroid と median だけは素朴な実装で3乗になり、メモリは全手法で2乗のオーダーです。件数が10倍になると、2乗の手法では計算量とメモリが約100倍、centroid と median では計算量が約1,000倍になります。
距離行列のメモリ量は件数の2乗で増え、5万件で約10GB
どこで詰まるかは距離行列の大きさで見積もれます。pdistが返す圧縮形式の距離行列は n×(n-1)÷2 個の値を持ち、倍精度なら1個8バイトです。
| 件数 | 距離の個数 | 距離行列のメモリ |
|---|---|---|
| 1万件 | 約5,000万 | 約0.4GB |
| 3万件 | 約4.5億 | 約3.6GB |
| 5万件 | 約12.5億 | 約10.0GB |
| 10万件 | 約50億 | 約40.0GB |
これは距離配列だけの量で、計算中の作業領域は含みません。Core i9-9880H・メモリ16GBのMacで、5変数の乱数データにSciPy 1.18.1のウォード法をかけて測ると、1万件で10.8秒・ピークメモリ0.90GB、2万件で51.7秒・3.22GBでした。件数を2倍にすると時間は約4.8倍、ピークメモリは約3.6倍に増え、ピークは距離配列(1万件0.4GB、2万件1.6GB)の約2倍です。実行できる上限は搭載メモリ、手法、許容時間で決まるので、本番の数分の1の件数で測ってから見積もってください。メモリか時間が足りない規模では、k-meansで数百のクラスタに粗く分け、その重心に階層的クラスタリングをかけてデンドログラムを描く二段構えが使えます。各重心を1点として扱うと元クラスタの件数は統合計算に反映されず、特にウォード法では統合順序も変わり得ます。元データへの階層的クラスタリングとは異なる近似結果として扱い、各重心の代表件数を併記してください。
デンドログラムで分析を進める条件と別の手法へ切り替える場面
デンドログラムを使うべきなのは、次の3つがそろう場合です。
- 距離配列と作業領域が手元のメモリに収まり、許容時間内に計算できる
- グループ数を事前に決められず、関係者と図を見ながら決めたい
- どの塊とどの塊が近いかという関係も説明に使いたい
次の場面では見送ります。
- 距離配列と作業領域がメモリに収まらない、または再計算が許容時間を超える。群が球状に近いと想定できるならk-meansを検討します。二段構えも候補ですが、最初のk-meansによる分割が残したい群の構造を壊さないかを小規模データで確認します
- しきい値を少し動かすだけでクラスタ数が変わり、高さのジャンプが見当たらない。その設定では切る高さを決めにくいので、距離尺度・標準化・業務上必要な分割数を見直します
- コサイン距離が前提なのに、ウォード法の見やすさを優先したくなる。群平均法へ替えるか、正規化してからユークリッド距離で扱います
- 既存の正解ラベルを新しいデータにも予測したい。決定木などの教師あり学習のほうが目的に合います
見つけたセグメントや異常候補を、予測モデルや業務システムの判定ロジックとして継続運用する段階では、特徴量の設計、再学習の頻度、精度の監視まで含めた設計が必要です。一創では機械学習モデル開発として、クラスタリングを含む分析の設計から業務システムへの組み込みまでを受託しています。
よくある質問
デンドログラムの見方は?どこから読めばよいですか?
縦軸の距離尺度を確認し、合流点の高さを下から追って、大きなジャンプの直前を切断候補にします。横方向の葉の並び順は描画の都合で決まるだけなので、隣接していることを似ている根拠にしないでください。
ウォード法とは何ですか?他のリンケージとどう違いますか?
クラスタを統合したときのクラスタ内平方和の増加がもっとも小さい組み合わせを選ぶ手法で、Ward (1963) が原典です。大きいクラスタ同士の統合に強いペナルティがかかるため、サイズのそろったクラスタができやすくなります。前提はユークリッド距離で、Rでは ward.D2 を指定します。
階層的クラスタリングと非階層的クラスタリングの違いは?
階層的クラスタリングはクラスタ数を決めずに統合の履歴をすべて残し、後からデンドログラム上で分割数を選びます。非階層的手法のうちk-meansは、実行前にクラスタ数を指定して所属とクラスタ中心を求めます(DBSCANのように、クラスタ数を事前に指定しない非階層的手法もあります)。切り替えは、距離配列と作業領域がメモリに収まるか、許容時間内に計算できるかで判断します。SciPyのウォード法では2万件で約52秒、ピークメモリ約3.2GBでした。
デンドログラムと系統樹・クラドグラムは同じものですか?
一部が重なります。種同士の類似度から距離ベースで作る系統樹(UPGMAなど)は、階層的クラスタリングの出力そのもので、デンドログラムと呼んで差し支えありません。最尤法やベイズ法で進化モデルを推定して作る系統樹は構築原理が異なります。クラドグラムは分岐の順序(共通祖先の関係)だけを示す図で、枝の長さや高さに距離の意味を持たせない点がデンドログラムと違います。
Excelでデンドログラムは作れますか?
Excelの標準のグラフ種類にデンドログラムはありません。Microsoftのグラフの種類の一覧で階層構造を扱えるのはツリーマップとサンバーストで、どちらも距離を高さで表す図ではありません。PythonのSciPyかRのhclustで描いて画像として貼り付けるか、統計ソフトのアドインを使うのが現実的です。