MCMC(Markov Chain Monte Carlo、マルコフ連鎖モンテカルロ法)は、式は書けても直接は計算できない確率分布から、乱数で標本を引いてくる手法です。「目標の分布に落ち着くように設計したマルコフ連鎖」を長く走らせ、その足跡を標本として使います。主な用途はベイズ推定で、事後分布の平均や信用区間を、積分を解かずに標本の集計で求めます。
この記事では、遷移行列で定義したマルコフ連鎖をPythonでシミュレーションし、どこから出発しても同じ分布に落ち着く様子を確かめたうえで、MH法の実装、R-hat・ESSによる収束判定、多峰性の分布で使うレプリカ交換法、PyMCでの発散の確認までを、実行した出力とあわせて説明します。なお、日本産婦人科医会の「母と子のメンタルヘルスケア(MCMC)」は同じ略称の別の取り組みで、この記事では扱いません。
まとめ:MCMCの要点と使うときの判断基準
- MCMCは、正規化定数(ベイズ推定なら周辺尤度)が計算できない分布でも、密度の比さえ計算できれば標本を引ける
- 標本は互いに相関するため、引いた個数ではなく有効サンプルサイズ(ESS)で精度を見る
- 収束判定は、初期値をばらした4本以上のチェーンで R-hat が1.01未満、順位正規化した ESS が400を超えるかを確認する(Vehtari et al. 2021 の推奨)
- R-hat は「どのチェーンも訪れていない山」を検出できない。山が複数ある分布では、全チェーンを同じ山から出すと半分を見落としたまま R-hat が1.001になった
- 連続パラメータで勾配を計算できるモデルは NUTS から始め、発散が出たら
target_acceptを上げる前に非中心化パラメータ化を試す - 間引き(thinning)は通常不要で、同じ連鎖なら標本を捨てずに推定する。ただし、保存容量の制約や標本ごとの後処理が高コストな場合には検討する
MCMCの仕組み|正規化定数が分からない分布から標本を得る考え方
ベイズ推定で事後分布を直接計算できない理由|周辺尤度の積分と計算量
ベイズの定理では、事後分布は「尤度×事前分布÷周辺尤度」で表されます。分子はモデルを書けば計算できますが、分母の周辺尤度はパラメータ全体にわたる積分です。共役事前分布のように式で解ける組み合わせは限られ、格子点で数値積分する方法は、1次元あたり100点でも10次元で100の10乗点が必要になり、次元が増えるほど計算量が指数的に膨らみます。
MCMCはこの分母を避けて通ります。後述する受容確率は「提案先と現在地の密度の比」だけで決まり、比を取ると分母は約分されて消えるためです。ベイズの定理そのものの意味はベイズの定理の公式と具体例で扱っています。
目標分布を定常分布にする遷移ルールの設計|詳細釣り合い条件の役割
マルコフ連鎖は、次の状態が現在の状態だけで決まる確率過程です。条件(既約性・非周期性など)を満たす連鎖は、どこから出発しても長く走らせると同じ分布に落ち着きます。この行き着く先が定常分布です。
MCMCはこの性質を逆向きに使います。先に「定常分布が目標分布(事後分布)になる」ように遷移のルールを作り、連鎖を走らせて、落ち着いた後の状態を標本として集めます。遷移ルールの設計に使われる代表的な十分条件が詳細釣り合い条件で、任意の2状態 x、y について「x にいる確率×x から y へ移る確率」と「y にいる確率×y から x へ移る確率」が等しいことを求めます。これを満たせば目標分布は定常分布になります。遷移行列と定常分布の計算例はマルコフ連鎖の仕組みと遷移行列・定常分布にまとめています。
マルコフ連鎖のPythonシミュレーション|定常分布への収束
「どこから出発しても同じ分布に落ち着く」という性質は、実際に連鎖を動かすと確かめられます。ここでは晴れ・曇り・雨の3状態をとる天気のモデルを、Pythonの標準ライブラリだけでシミュレーションします。遷移行列は、行が今日の天気、列が明日の天気で、各行の確率の和は1です。
| 今日\明日 | 晴れ | 曇り | 雨 |
|---|---|---|---|
| 晴れ | 0.7 | 0.2 | 0.1 |
| 曇り | 0.3 | 0.4 | 0.3 |
| 雨 | 0.2 | 0.3 | 0.5 |
遷移行列による状態更新|Python標準ライブラリでの実装
次の状態を引く処理は、Python公式ドキュメントの random モジュールにある random.choices に、今の状態の行を重みとして渡すだけです。同じ種(seed)を与えた random.Random を使うと、何度実行しても同じ経路が再現できます。
import random

# 状態: 晴れ・曇り・雨。行=今日、列=明日の遷移確率(各行の和は1)
states = ["晴れ", "曇り", "雨"]
P = [
    [0.7, 0.2, 0.1],
    [0.3, 0.4, 0.3],
    [0.2, 0.3, 0.5],
]

def simulate(n_steps, start, seed):
    rng = random.Random(seed)
    x = [start]
    for _ in range(n_steps - 1):
        # 今の状態の行だけを見て、次の状態を重み付きで1つ引く
        x.append(rng.choices(range(3), weights=P[x[-1]])[0])
    return x

def step(dist):
    # 分布ベクトル × 遷移行列(1日進める)
    return [sum(dist[i] * P[i][j] for i in range(3)) for j in range(3)]

# 1) 雨の日から出発した10日分の経路
print("経路:", " → ".join(states[s] for s in simulate(10, start=2, seed=1)))

# 2) 10万日走らせた滞在割合
x = simulate(100_000, start=2, seed=0)
print("滞在割合:", [round(x.count(s) / len(x), 3) for s in range(3)])

# 3) 出発点を変えて、n日後の分布を比べる
for start in range(3):
    dist = [1.0 if s == start else 0.0 for s in range(3)]
    row = []
    for n in range(1, 31):
        dist = step(dist)
        if n in (1, 3, 10, 30):
            row.append(f"{n}日後={[round(p, 3) for p in dist]}")
    print(f"{states[start]}から:", " ".join(row))
Python 3.14.6 で実行した出力です(2026年10月14日実行)。
経路: 雨 → 晴れ → 曇り → 雨 → 曇り → 曇り → 曇り → 曇り → 雨 → 晴れ
滞在割合: [0.457, 0.282, 0.261]
晴れから: 1日後=[0.7, 0.2, 0.1] 3日後=[0.51, 0.268, 0.222] 10日後=[0.457, 0.283, 0.261] 30日後=[0.457, 0.283, 0.261]
曇りから: 1日後=[0.3, 0.4, 0.3] 3日後=[0.426, 0.292, 0.282] 10日後=[0.456, 0.283, 0.261] 30日後=[0.457, 0.283, 0.261]
雨から: 1日後=[0.2, 0.3, 0.5] 3日後=[0.396, 0.298, 0.306] 10日後=[0.456, 0.283, 0.261] 30日後=[0.457, 0.283, 0.261]
10万日の滞在割合と定常分布の一致|初期状態による違いの減衰
定常分布 π は「π に遷移行列を掛けても π のまま」という連立方程式を解けば求まります。この行列で解くと、晴れ 21/46≒0.457、曇り 13/46≒0.283、雨 12/46≒0.261 です。10万日のシミュレーションの滞在割合 [0.457, 0.282, 0.261] は、この値と小数第2位まで一致しました。状態数が多い場合は、NumPy公式の linalg.eig で遷移行列の転置の固有値1に対応する固有ベクトルを求め、和が1になるよう割ると同じ値が得られます。
出発点を変えた3行の出力では、1日後の分布は出発点ごとに大きく異なりますが、10日後にはどの出発点からも [0.456〜0.457, 0.283, 0.261] にそろい、30日後には3行が小数第3位まで同じ値になりました。これが「初期値の影響が消える」ということで、MCMCのバーンイン(先頭の標本を捨てる処理)はこの現象を前提にしています。
シミュレーションとMCMCの違い|遷移行列と目標分布の順序
天気の例では、遷移行列から定常分布を求めました。MCMCは向きが逆で、「定常分布にしたい分布(事後分布)が先にあり、それを定常分布に持つ遷移を後から作る」手法です。状態が連続値で数え上げられない事後分布でも、MH法の受容確率を使えば、その分布に落ち着く遷移を密度の比だけで組み立てられます。
なお、上の天気の行列は詳細釣り合い条件を満たしていません。晴れから曇りへの流れは 21/46×0.2=4.2/46、曇りから晴れへの流れは 13/46×0.3=3.9/46 で、一致しないためです。それでも定常分布は存在します。詳細釣り合いは定常分布を持たせるための十分条件であり、MCMCではこの条件を満たすように遷移を設計すると、目標分布が定常分布になることを確かめやすくなります。
モンテカルロ法・マルコフ連鎖との違い|MCMCの標本間の相関
モンテカルロ法は、乱数で標本を作り、その平均で期待値や積分を近似する手法全般を指します。円周率を点の打ち込みで求める例が代表で、標本同士は独立です。MCMCはモンテカルロ法の一種ですが、標本をマルコフ連鎖で1つずつ作るため、隣り合う標本が似た値になります。天気のシミュレーションでも、曇りが4日続くように、隣り合う日の状態は独立ではありません。
| 手法 | 標本の作り方 | 標本同士 | 必要な情報 |
|---|---|---|---|
| 通常のモンテカルロ法 | 目標分布から直接引く | 独立 | 直接引ける分布であること |
| 棄却サンプリング | 提案して一定確率で捨てる | 独立 | 密度を上から覆う分布 |
| MCMC | 前の標本から次を作る | 相関あり | 密度の比(正規化不要) |
正の自己相関が強いと、同じ個数の独立な標本より推定精度が低くなります。その影響を表すのが後述のESSです(負の自己相関でESSが標本数を上回る場合もあります)。独立な標本を作る側の手法はモンテカルロ法の仕組みと円周率・リスク評価での使い方、棄却サンプリングの受容率とPython実装で扱っています。棄却サンプリングは、高次元で目標密度に近い提案分布と適切な上界を用意できないと受容率が落ちるため、そうした事後分布ではMCMCが選択肢になります。
代表的なMCMCアルゴリズム|MH法・ギブスサンプリング・HMC/NUTSの使い分け
| 手法 | 原論文 | 必要なもの | 向く場面 |
|---|---|---|---|
| メトロポリス法 | Metropolis et al. 1953 | 密度の比 | 低次元・学習用 |
| MH法 | Hastings 1970 | 密度の比+提案分布 | 非対称な提案が要る場合 |
| ギブスサンプリング | Geman & Geman 1984 | 各変数の条件付き分布 | 共役な階層モデル |
| HMC | Duane et al. 1987 | 密度の勾配 | 連続パラメータの多次元モデル |
| NUTS | Hoffman & Gelman 2014 | 密度の勾配 | Stan・PyMCの既定 |
| レプリカ交換法 | Hukushima & Nemoto 1996 | 温度を変えた複数の連鎖 | 山が複数ある分布 |
選び方の軸は「勾配が計算できるか」「条件付き分布が既知か」「山が複数あるか」の3つです。パラメータが連続で自動微分が使えるならNUTS、離散パラメータを含むならギブスやMHを組み合わせ、山が離れて複数あるならレプリカ交換法を重ねます。
メトロポリス・ヘイスティングス法の受容確率と提案分布の幅が効率を決める仕組み
MH法は、現在地 x から提案分布 q で候補 x’ を作り、確率 min(1, π(x’)q(x|x’) / π(x)q(x’|x)) で移動し、却下なら x に留まります。π は目標分布の密度です。提案分布が対称(正規分布によるランダムウォークなど)なら q が約分され、密度の比だけで決まるメトロポリス法になります。
効率を左右するのは提案分布の幅です。幅が狭いと受容率は高くても少しずつしか動かず、広いと候補がほとんど却下されます。Roberts, Gelman, Gilks(1997)は、同一の1次元密度の積を目標分布とし、正規ランダムウォーク提案を用いる高次元極限で、漸近的に効率が最も高くなる受容率が約0.234であることを示しました。次章の実測では、この幅の違いがESSに直接表れます。
ギブスサンプリングが使える条件|条件付き分布が既知で相関の弱いモデル
ギブスサンプリングは、パラメータを1つずつ、他を固定した条件付き分布から直接引く方法です。提案の却下が起きないため調整の手間がなく、共役事前分布を使った階層モデルや混合ガウスモデルのように条件付き分布が標準的な分布になる場合に向きます。BUGSやJAGSがこの方式を中心にしたソフトウェアです。
弱点はパラメータ同士の相関です。2変量標準正規分布をギブスで4チェーン×1万標本(計4万標本)引き、ArviZでESSを測ると、相関0で39,565、相関0.9で4,143、相関0.99で432でした。1軸ずつしか動けないため、相関が強い細長い分布では斜め方向へほとんど進めません。相関の強いモデルでは、再パラメータ化して相関を外すか、HMC/NUTSに切り替えます。
HMCとNUTSの特徴|勾配を使った候補生成と軌道長の調整
HMC(ハミルトニアンモンテカルロ法)は、密度の勾配を使って物理の運動のように遠くの候補を作るため、ランダムウォークより少ない反復で分布全体を動けます。ただしステップ幅と軌道の長さという2つの調整値に敏感です。NUTS(No-U-Turn Sampler)は軌道の長さを自動で決める改良版で、CmdStanの既定サンプラーもNUTSです。CmdStanの既定値は、ウォームアップ1,000回・本サンプリング1,000回・目標受容率(adapt delta)0.8・木の最大深さ10です。
PythonでMH法を実装する|コイン投げの事後分布を解析解と照合
答えが分かっている問題で動かすと、MCMCの挙動を確かめられます。コインを10回投げて7回表が出たとき、表の確率 p の事後分布は、一様な事前分布 Beta(1,1) のもとで Beta(8,4) になり、事後平均は 8/12=0.667 です。これをMH法で求めます。NumPy以外のライブラリは使いません(NumPyの基本はNumPyの読み方と基本的な使い方を参照)。天気のシミュレーションと違い、ここでは遷移行列を書かず、受容確率のルールだけで「Beta(8,4) に落ち着く連鎖」を作っています。
import numpy as np

# 観測: コインを10回投げて表が7回。事前分布は一様分布 Beta(1,1)
n, k = 10, 7

def log_post(p):
    if p <= 0 or p >= 1:
        return -np.inf                             # 範囲外は確率0
    return k * np.log(p) + (n - k) * np.log(1 - p)   # 正規化定数は不要

def metropolis(step, n_iter=20000, init=0.5, seed=0):
    rng = np.random.default_rng(seed)
    p, lp = init, log_post(init)
    chain, accepted = np.empty(n_iter), 0
    for i in range(n_iter):
        prop = p + rng.normal(0, step)             # 対称な提案分布(ランダムウォーク)
        lp_prop = log_post(prop)
        if np.log(rng.uniform()) < lp_prop - lp:   # 受容確率 min(1, π(prop)/π(p))
            p, lp = prop, lp_prop
            accepted += 1
        chain[i] = p
    return chain, accepted / n_iter

def split_rhat(chains):
    # 各チェーンを前半・後半に割り、チェーン間とチェーン内の分散を比べる
    half = chains.shape[1] // 2
    c = np.vstack([chains[:, :half], chains[:, half:2 * half]])
    m, L = c.shape
    W = c.var(axis=1, ddof=1).mean()
    B = L * c.mean(axis=1).var(ddof=1)
    return np.sqrt(((L - 1) / L * W + B / L) / W)

def ess(x):
    # 自己相関が負に転じる手前までを足し合わせる単純な推定
    x = x - x.mean()
    n = len(x)
    acf = np.correlate(x, x, mode="full")[n - 1:] / (x.var() * n)
    s = 0.0
    for t in range(1, n):
        if acf[t] < 0:
            break
        s += acf[t]
    return n / (1 + 2 * s)

for step in (0.01, 0.2, 2.0):
    chains, rates = [], []
    for seed, init in enumerate((0.1, 0.4, 0.6, 0.9)):   # 初期値をばらした4本
        ch, r = metropolis(step, init=init, seed=seed)
        chains.append(ch[2000:])                          # 先頭2,000回はバーンイン
        rates.append(r)
    chains = np.array(chains)
    print(f"step={step:<5} 受容率={np.mean(rates):.2f} "
          f"事後平均={chains.mean():.3f} R-hat={split_rhat(chains):.3f} "
          f"ESS={sum(ess(c) for c in chains):.0f}")
Python 3.9・NumPy 2.0.2 で実行した出力です(初期値0.1/0.4/0.6/0.9の4本、各2万回からバーンイン2,000回を捨てた計72,000標本)。
step=0.01  受容率=0.98 事後平均=0.672 R-hat=1.042 ESS=133
step=0.2   受容率=0.59 事後平均=0.667 R-hat=1.000 ESS=13601
step=2.0   受容率=0.08 事後平均=0.667 R-hat=1.002 ESS=3365
提案分布の幅による受容率とESSの変化|受容率98%でも混ざらない例
| 提案の幅 | 受容率 | 事後平均 | R-hat | ESS(72,000標本中) |
|---|---|---|---|---|
| 0.01 | 0.98 | 0.672 | 1.042 | 133 |
| 0.2 | 0.59 | 0.667 | 1.000 | 13,601 |
| 2.0 | 0.08 | 0.667 | 1.002 | 3,365 |
幅0.01は受容率98%で、一見うまく動いているように見えます。しかしESSは72,000標本に対して133にとどまり、R-hatも1.042で基準の1.01を超えています。受容率が高いことは、よく混ざっていることを意味しません。幅0.2では事後平均が解析解の0.667と一致し、ESSは幅0.01の約100倍になりました。同じ関数で幅0.2・初期値0.5・seed=42として102,000回走らせ、先頭2,000回を除いた10万標本の2.5・97.5パーセンタイルは [0.385, 0.890] で、Beta(8,4) の理論上の95%信用区間(等裾)[0.390, 0.891] とほぼ重なります。
このコードの R-hat と ESS は仕組みを示すための簡易版です。実務では、順位正規化した R-hat と bulk/tail ESS を計算する ArviZ や Stan の関数を使ってください。
MCMCの収束判定|R-hat・ESS・トレースプロットの見方
R-hat(Gelman-Rubin統計量)の計算式と1.01未満という基準
R-hat は、初期値を変えた複数チェーンについて「チェーン間のばらつき」と「チェーン内のばらつき」を比べる指標です。Stanリファレンスマニュアルの事後分析の章は、チェーン数を M、各チェーンの長さを N として次のように定義しています。
- チェーン間分散 B = N/(M−1) × Σ(各チェーンの平均 − 全体平均)²
- チェーン内分散 W = 各チェーンの標本分散 s²(N−1で割る)の平均
- 事後分散の推定 var⁺ = (N−1)/N × W + B/N
- R-hat = √(var⁺ / W)
全チェーンが同じ分布に落ち着いていれば B が小さくなり、var⁺ と W がほぼ等しくなって R-hat は1に近づきます。上のMH法のコードの split_rhat は、この式を各チェーンを前半・後半に割った列に当てたものです。Gelman & Rubin(1992)の原論文は、ここにStudentのt分布の追加分散を補正する係数を掛けており、現在のソフトウェアが出す値とは厳密には同じ式ではありません。
基準値は、かつて1.1未満が目安とされていました。Vehtari et al.(2021)のR-hatとESSの論文は、従来の R-hat が収束前でも1.1を下回る例を示したうえで、順位正規化と折り返し(folding)を加えた R-hat を提案し、1.01未満を基準とし、既定では少なくとも4本のチェーンを走らせることを推奨しています。ArviZの az.rhat や az.summary の r_hat 列は、この改良版です。
ESS(有効サンプルサイズ)による推定精度の評価とbulk・tailの違い
ESSは、相関のある標本列が独立な標本何個分の情報を持つかを表します。事後平均のモンテカルロ誤差はおよそ「事後標準偏差÷√ESS」なので、ESSが100なら誤差は標準偏差の1割です。ArviZや Stan は分布の中心部を見る bulk-ESS と、裾(信用区間の端)を見る tail-ESS を分けて出力します。Vehtari et al. は、R-hatとESSの推定を安定させる目安として、順位正規化した ESS が400を超えることを推奨しています。ただし、400は必要な推定精度を保証する値ではなく、報告する平均や分位点のモンテカルロ標準誤差が用途上十分小さいかも確認します。信用区間を報告するなら tail-ESS も確認します。
トレースプロットの診断|ギザギザの帯とチェーン間の重なり
トレースプロットは、横軸に反復回数、縦軸に標本の値を描いた図です。収束して混ざりのよいチェーンは、一定の帯の中を細かく上下する毛虫のような「ギザギザ」になり、複数チェーンの線が重なります。逆に、ゆっくり波打つ、途中で水準が変わる、チェーンごとに別の高さに張り付く、といった形は収束していないサインです。上の実測で幅0.01のチェーンは、100回離れた標本同士でも自己相関が0.71残っており(幅0.2では10回離れると0.03)、ゆっくり波打つ形になります。
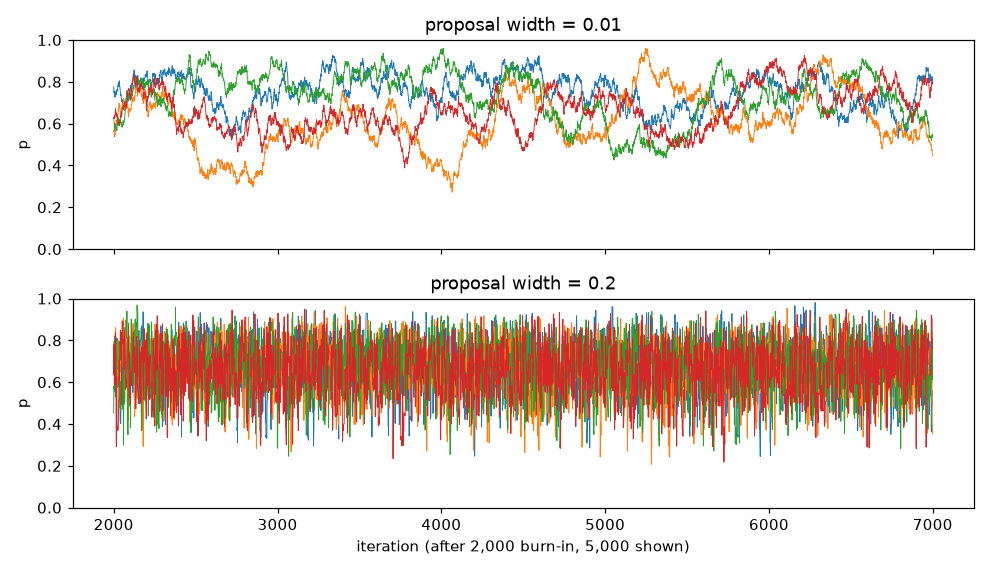
上の図は、コイン投げのMH法(初期値0.1/0.4/0.6/0.9の4チェーン)から、バーンイン2,000回を除いた後の5,000回を同じ縦軸(0〜1)で並べたものです。上段の幅0.01は線がチェーンごとに別の高さをさまよい、下段の幅0.2は4本が0.4〜0.9の帯の中で細かく上下して重なります。後者が「ギザギザ」の正常な形です。ArviZの az.ess で測ると、72,000標本中の bulk-ESS は幅0.01で104、幅0.2で13,764でした。
バーンインと間引き(thinning)の扱い|除外後の診断と間引きの適用条件
初期値の影響を減らすため、先頭部分をバーンインとして除外します。Stan・PyMCのウォームアップ(チューニング)では、これに加えてステップ幅などのサンプラー設定も調整する点が、単純なバーンインとの違いです。何回捨てるかに固定の正解はなく、捨てた後の R-hat と ESS で足りたかを判断します。
一方、k個おきに標本を残す間引き(thinning)は、自己相関を下げる目的では使いません。Link & Eaton(2012)の間引きに関する論文は、平均・分散・百分位点の推定は間引かない連鎖のほうが精密になるとし、メモリの制約で必要な場合を除いて機械的な間引きを推奨していません。間引くと相関は下がって見えますが、捨てた標本の情報も失うためです。
多峰性の分布で連鎖が山に閉じ込められる問題|レプリカ交換法による探索
MCMCで探索が難しくなる代表例は、確率の高い領域(山)が離れて複数ある分布です。統計数理研究所のMCMCチュートリアルも「MCMCが困難に陥る場合」として挙げる問題で、混合分布や、ラベルの入れ替えで同じ尤度になるモデルで実際に起きます。山と山の間の谷は密度がほぼ0なので、ランダムウォークの提案はそこへ進む候補をほぼ必ず却下し、連鎖は最初に入った山から出られません。
片方の山しか訪れないチェーンと、それを見逃す R-hat
目標分布を 0.5×N(−5, 1) + 0.5×N(5, 1)(−5と5に同じ高さの山が2つ)として、提案幅1.0のMH法を−5から5万回走らせると、3通りの乱数種のすべてで右の山の滞在割合は0.000、平均は約−5.0でした。本当の平均は0なので、分布の半分を丸ごと見落としています。
この見落としは R-hat でも検出できない場合があります。同じMH法で4本のチェーンを走らせ(各2万回、先頭2,000回を除外)、ArviZの az.rhat で測った結果が次の表です。
| 初期値 | 右の山の割合(チェーン別) | 平均 | R-hat |
|---|---|---|---|
| 4本とも左の山(−6〜−4.5) | 0, 0, 0, 0 | −5.01 | 1.001 |
| 左右に2本ずつ(±5, ±6) | 0, 1, 0, 1 | 0.00 | 1.734 |
4本とも左から出した場合、全チェーンが同じ誤った分布に落ち着いているため、R-hat は1.001で「収束」と判定されます。R-hat が比べているのはチェーン同士の一致であり、どのチェーンも訪れていない山の存在は分かりません。乱数種を変えた別の試行では、4本のうち1本が一度だけ谷を越えて右の山に32.5%滞在し、チェーン間の違いが現れたことで R-hat が1.129に上がりました。全チェーンを同じ山から出すと、こうした偶然の越境が起きない限り警告は出ません。山が複数ありうるモデルでは、初期値を事前分布の広い範囲に散らし、チェーンごとの平均がそろっているかを個別に確認します。
レプリカ交換法(パラレルテンパリング)の仕組みとPython実装
レプリカ交換法は、温度を変えた複数の連鎖(レプリカ)を同時に走らせ、ときどき隣り合う温度の状態を入れ替える方法です。福島孝治・根本幸児の交換モンテカルロ法の論文(Hukushima & Nemoto 1996)がスピングラスのシミュレーション向けに提案しました。逆温度 β を掛けた分布 π(x)^β は、β が小さいほど山が平らになり、谷を越えやすくなります。高温側のレプリカが山を渡り、交換によってその状態が β=1 のレプリカへ降りてくることで、本来の分布でも山を行き来できるようになります。交換の受容確率は min(1, exp((β_k − β_(k+1)) × (log π(x_(k+1)) − log π(x_k)))) で、これも密度の比だけで計算できます。
import numpy as np

# 目標: 2つの山 0.5*N(-5,1) + 0.5*N(5,1)(正規化定数は使わない)
def log_p(x):
    return np.logaddexp(-0.5 * (x + 5) ** 2, -0.5 * (x - 5) ** 2)

def mh(n_iter, step, seed, init=-5.0):
    rng = np.random.default_rng(seed)
    x, lp = init, log_p(init)
    out = np.empty(n_iter)
    for i in range(n_iter):
        prop = x + rng.normal(0, step)
        lp_prop = log_p(prop)
        if np.log(rng.uniform()) < lp_prop - lp:
            x, lp = prop, lp_prop
        out[i] = x
    return out

def tempering(n_iter, step, betas, seed, init=-5.0):
    # betas: 逆温度。β=1 が本来の分布、β が小さいほど山が平らになる
    rng = np.random.default_rng(seed)
    K = len(betas)
    x = np.full(K, init)
    out = np.empty(n_iter)
    swaps, tries = 0, 0
    for i in range(n_iter):
        for k in range(K):  # 各レプリカで通常のMH更新(温度ごとに提案幅を広げる)
            s = step / np.sqrt(betas[k])
            prop = x[k] + rng.normal(0, s)
            if np.log(rng.uniform()) < betas[k] * (log_p(prop) - log_p(x[k])):
                x[k] = prop
        k = rng.integers(K - 1)  # 隣り合う温度の状態を交換する提案
        tries += 1
        a = (betas[k] - betas[k + 1]) * (log_p(x[k + 1]) - log_p(x[k]))
        if np.log(rng.uniform()) < a:
            x[k], x[k + 1] = x[k + 1], x[k]
            swaps += 1
        out[i] = x[0]  # β=1 のレプリカだけを標本として使う
    return out, swaps / tries

n = 50_000
for seed in range(3):
    a = mh(n, step=1.0, seed=seed)
    b, rate = tempering(n, step=1.0, betas=[1.0, 0.3, 0.1, 0.03], seed=seed)
    print(f"seed={seed} MH: 右の山の割合={np.mean(a > 0):.3f} 平均={a.mean():+.2f} 山の移動={np.sum(np.diff(np.sign(a)) != 0)}回 | "
          f"レプリカ交換: 右の山の割合={np.mean(b > 0):.3f} 平均={b.mean():+.2f} 山の移動={np.sum(np.diff(np.sign(b)) != 0)}回 交換受容率={rate:.2f}")
Python 3.12.13・NumPy 2.3.5 で実行した出力です(2026年10月25日実行)。「山の移動」は標本の符号が変わった回数です。
seed=0 MH: 右の山の割合=0.000 平均=-4.99 山の移動=0回 | レプリカ交換: 右の山の割合=0.495 平均=-0.05 山の移動=5352回 交換受容率=0.69
seed=1 MH: 右の山の割合=0.000 平均=-4.99 山の移動=0回 | レプリカ交換: 右の山の割合=0.504 平均=+0.06 山の移動=5291回 交換受容率=0.68
seed=2 MH: 右の山の割合=0.000 平均=-5.01 山の移動=0回 | レプリカ交換: 右の山の割合=0.520 平均=+0.20 山の移動=5302回 交換受容率=0.69
同じ提案幅1.0でも、逆温度 [1.0, 0.3, 0.1, 0.03] の4レプリカを重ねると、β=1 の連鎖が5万回のうち約5,300回山を行き来し、右の山の割合は0.495〜0.520と本来の0.5に近づきました。温度の段数と間隔は、隣同士の交換受容率が低くなりすぎない(この例では0.68〜0.69)ように決めます。最も高温のレプリカが谷を越えられないと、段数を増やしても山は渡れません。計算量はレプリカ数に比例して増えるため、山が1つと分かっている事後分布には使いません。
PyMCでMCMCを回す|az.summaryの読み方と発散の数え方
実務のベイズモデルは、MH法を自作せずライブラリのNUTSで回します。ここでは PyMC 6.3.2・ArviZ 1.3.0・nutpie 0.16.11(Python 3.12.13、16コアのmacOS)で実行した結果を示します。
コイン投げの事後分布のPyMC推定|自作MH法との比較
import pymc as pm
import arviz as az

if __name__ == "__main__":
    # コインを10回投げて表が7回。事前分布は一様分布 Beta(1,1)
    with pm.Model():
        p = pm.Beta("p", alpha=1, beta=1)
        pm.Binomial("y", n=10, p=p, observed=7)
        idata = pm.sample(random_seed=1)       # 既定: draws=1000, tune=1000
    print(az.summary(idata, var_names=["p"]))
mean sd eti89_lb eti89_ub ess_bulk ess_tail r_hat mcse_mean mcse_sd
p 0.665 0.13 0.44 0.86 1736 2107 1.00 0.0031 0.0017mean 0.665 は解析解の0.667とほぼ一致し、r_hat は1.00、ess_bulk は1,736です。pm.sample はチェーン数を省略すると、並列数をCPU数と4の小さい方、チェーン数をその並列数と2の大きい方に決めるため、この環境では4チェーン×1,000標本=4,000標本になりました。自作MH法(幅0.2)の72,000標本を同じ az.ess で測ると bulk-ESS は13,764で、1標本あたり約0.19でした。NUTSは1標本あたり約0.43(1,736÷4,000)で、同じ物差しで比べても1標本が持つ情報は2倍強です。ArviZ 1.x の要約は既定で89%の等裾区間(eti89_lb・eti89_ub 列)を出し、0.x 系の hdi_3%・hdi_97% 列は出ません。古い記事の出力と列名が違うのはこのためです。
発散(divergences)の集計|非中心化パラメータ化による改善
NUTSの発散(divergent transitions)は、軌道の数値計算が破綻した反復で、その付近の事後分布を正しく探索できていないサインです。発散が出やすい典型が、階層モデルで標準偏差パラメータ tau が0付近に寄る「漏斗型」の事後分布です。PyMC公式の発散の診断例と同じ8 schools(8校の学習効果)のデータで、中心化と非中心化を比べました。
import numpy as np
import pymc as pm
import arviz as az

# 8つの学校の効果の推定値 y と標準誤差 sigma(Rubin 1981 の例)
y = np.array([28, 8, -3, 7, -1, 1, 18, 12], dtype=float)
sigma = np.array([15, 10, 16, 11, 9, 11, 10, 18], dtype=float)

def fit(centered, target_accept):
    with pm.Model():
        mu = pm.Normal("mu", 0, 5)
        tau = pm.HalfCauchy("tau", 5)
        if centered:
            theta = pm.Normal("theta", mu, tau, shape=8)        # 中心化
        else:
            z = pm.Normal("z", 0, 1, shape=8)                   # 非中心化
            theta = pm.Deterministic("theta", mu + tau * z)
        pm.Normal("obs", theta, sigma, observed=y)
        return pm.sample(random_seed=1, progressbar=False,
                         nuts={"target_accept": target_accept})

if __name__ == "__main__":
    for centered in (True, False):
        for ta in (0.8, 0.9, 0.99):
            idata = fit(centered, ta)
            n_div = int(idata.sample_stats["diverging"].sum())
            s = az.summary(idata, var_names=["tau"])
            print(f"{'中心化' if centered else '非中心化'} target_accept={ta}: "
f"発散={n_div} tauのR-hat={s['r_hat'].iloc[0]:.3f} ess_bulk={s['ess_bulk'].iloc[0]:.0f}")| パラメータ化 | target_accept | 発散(4,000標本中) | tauのR-hat | tauのess_bulk |
|---|---|---|---|---|
| 中心化 | 0.8 | 35 | 1.083 | 68 |
| 中心化 | 0.9 | 11 | 1.018 | 201 |
| 中心化 | 0.99 | 4 | 1.074 | 57 |
| 非中心化 | 0.8 | 3 | 1.002 | 2,334 |
| 非中心化 | 0.9 | 0 | 1.003 | 1,795 |
| 非中心化 | 0.99 | 0 | 1.003 | 1,596 |
中心化のままでは、target_accept を0.99まで上げても発散は4件残り、tau の R-hat は1.074、ess_bulk は57で、収束の基準を満たしません。非中心化(theta を mu+tau×z と書き直し、z を標準正規から引く)にすると、0.8でも発散は3件、ess_bulk は2,334まで増え、0.9で発散は0になりました。発散が出たときは、まず再パラメータ化を試し、残った分を target_accept で詰める順が有効です。
target_accept の既定値には注意が要ります。PyMC 6.3.2 は nutpie(0.16.10以上)が入っていると条件次第で nutpie を自動で選び(ログに NUTS[nutpie] と出ます)、target_accept を指定しなければ nutpie 側の既定値0.8が使われます。PyMC公式の入門ノートブックには既定値を0.9とする記述がありますが、中心化モデルを指定なしで回した発散数(35件)は0.8を明示した実行と一致し、0.9を明示した実行(11件)とは異なりました。比較するときは nuts={"target_accept": 0.9} のように明示します。
MCMCライブラリの選び方|PyMC・Stan・NumPyroの違い
| ライブラリ | 最新版 | 書き方 | 向く場面 |
|---|---|---|---|
| PyMC | 6.3.2(2026-09-08) | Pythonでモデルを書く | Python中心の分析 |
| Stan(CmdStan) | 2.40.0(2026-09-16) | Stan言語で別ファイル | R・Pythonの両方から使う |
| NumPyro | 0.22.0(2026-09-18) | JAXベースのPython | GPUでの大規模計算 |
| ArviZ | 1.3.0(2026-08-11) | 診断・可視化専用 | 上記の結果の診断 |
版番号は2026年10月25日時点のPyMCのリリース履歴、CmdStan 2.40の公式リリース、NumPyroのリリース履歴、ArviZのリリース履歴で確認した値です。古い書籍やブログの import pymc3 は、2022年6月のv4.0で PyMC に改称される前の書き方です(PyMC3 の最終版は3.11.6、計算の土台は現在 PyTensor)。新規に使うなら pip install pymc で入る PyMC を選びます。
PyMCで実際のモデルを組み、収束診断まで通した例として、段階反応モデルをPyMCでベイズ推定する手順と収束診断があります。RからStanを使う場合の環境はR言語の言語仕様と環境構築もあわせて参照してください。
MCMCを使うべきでない場面と、収束を確かめずに報告する失敗
次の場面では、MCMCより先に別の手段を検討します。
- 事後分布が解析的に求まる:ベータ二項モデルのような共役な組み合わせなら、上の例のように式で答えが出ます。MCMCは検算用にとどめます。
- データ件数が多く、精度より速度が優先:各反復で全データの尤度を計算するため時間がかかります。変分推論(ADVI など)は近似誤差の検証が必要ですが、モデルによっては計算時間を短縮でき、PyMC・NumPyro とも実装を持っています。
- パラメータが識別できないモデル:ラベルの入れ替えで同じ尤度になる混合モデルなどでは、チェーンごとに別の山へ張り付き、R-hat が下がりません。レプリカ交換法で山を渡らせる前に、順序制約や再パラメータ化で山を1つにできないかを考えます。
避けるべき失敗は、NUTSの発散の警告を無視して結果を使うことと、チェーン1本・R-hat未確認のまま平均だけを報告することです。幅0.01の例では値がもっともらしいまま収束しておらず、多峰性の例では R-hat が1.001でも分布の半分を見落としていました。
需要の予測や設備・顧客の状態推移の予測のように、マルコフ連鎖やベイズモデルの結果を業務システムへ組み込む段階では、モデルの検証に加えて、データの更新周期や予測区間の見せ方まで設計が必要になります。一創のAI予測分析開発・需要予測開発では、こうした確率モデルを使った予測の検証から、業務システムへの実装までを支援しています。
よくある質問
MCMCは何回回せばよいですか?
回数に一律の基準はありません。まず4チェーンそれぞれでウォームアップ1,000回と本サンプリング1,000回を実行し、R-hat が1.01未満か、順位正規化した ESS が400を超えるかで判断します。足りなければ回数を増やすより先に、モデルの再パラメータ化を検討します。
マルコフ連鎖のシミュレーションとMCMCは何が違いますか?
向きが逆です。マルコフ連鎖のシミュレーションは遷移確率が先にあり、連鎖の動き(経路・滞在割合・定常分布)を調べます。MCMCは定常分布にしたい分布が先にあり、そこへ落ち着く遷移を作って標本を集めます。天気の例のように遷移行列が分かっていれば、定常分布は連立方程式で直接解けます。
MCMCと変分ベイズ法の違いは何ですか?
MCMCは十分長く回せば事後分布そのものに近づく標本を得る方法、変分ベイズ法は事後分布を扱いやすい分布族で近似し、その中で事後分布に最も近いものを探す最適化を解く方法です。変分ベイズ法は速い代わりに、近似分布の形で決まる偏り(分散を小さく見積もりがちなど)が残ります。精度を優先するならMCMC、速度を優先するなら変分ベイズ法、という使い分けが基本です。
MCMCはGPUで速くなりますか?
NumPyro は JAX による自動微分と JIT コンパイルで GPU・TPU・CPU 上で動き、NUTS の木構築まで含めてコンパイルします。PyMC でも pm.sample(nuts_sampler="numpyro") のように JAX 系の実装へ切り替えられます。効果が出やすいのは、勾配計算が重い大規模モデルや、多数のチェーンをまとめて回す場合です。
隠れマルコフモデルや状態空間モデルとMCMCの関係は?
隠れマルコフモデルや状態空間モデルは「観測の裏に、マルコフ連鎖に従う見えない状態がある」というモデルで、MCMCは「そのモデルのパラメータをどう推定するか」という計算手法です。線形・正規の状態空間モデルならカルマンフィルタで尤度を計算し、その尤度を使ってパラメータの事後分布をMCMCで求める、という組み合わせがよく使われます。カルマンフィルタ自体はカルマンフィルタの仕組みと使い方で解説しています。