セマンティックセグメンテーションは、画像の全画素に「道路」「人」「空」のようなクラスを1つずつ割り当てる画像認識タスクです。物体を四角で囲む物体検出と違い、出力は入力画像と同じ大きさのラベル地図になります。この記事では、インスタンス・パノプティックとの違い、FCNからMask2Formerまでのモデルの系譜、評価指標mIoUの計算方法を、numpyとtorchvisionで動かしたコード付きで解説します。
まとめ:セマンティックセグメンテーションの要点と導入判断
- 定義:画素ごとのクラス分類。同じクラスの物体に個体IDは付けません(人が3人いれば全員に同じ「人」のラベルを付け、誰がどの人かは区別しない)。個体を分けたいならインスタンスセグメンテーションを使います。
- 仕組み:エンコーダで解像度を落として意味を抽出し、デコーダで元の解像度へ戻す構造が基本です。戻す過程で失われる境界の情報を、スキップ結合や空洞畳み込みで補います。
- 代表モデル:FCN(2014年)が畳み込みだけで画素単位の出力を可能にし、U-Net・SegNet・PSPNet・DeepLabへと続きました。2021年にはSegFormerやMask2Formerなど、Transformerを用いる代表的なモデルが提案されました。
- 評価:主指標はmIoU(クラスごとのIoUの平均)です。画素精度(Pixel Accuracy)は背景が多いと高く出るため、単独では判断に使えません。
- 導入判断:画素単位のアノテーションには大きな工数がかかります。Cityscapesでは1枚の精密な注釈に平均1.5時間以上かかっています。個数や位置が分かれば足りる用途なら、物体検出を選ぶほうが安く済みます。
以下、他タスクとの違い、仕組み、モデル、評価指標、実装、導入判断の順に説明します。
セマンティックセグメンテーションの定義とインスタンス・パノプティックとの違い
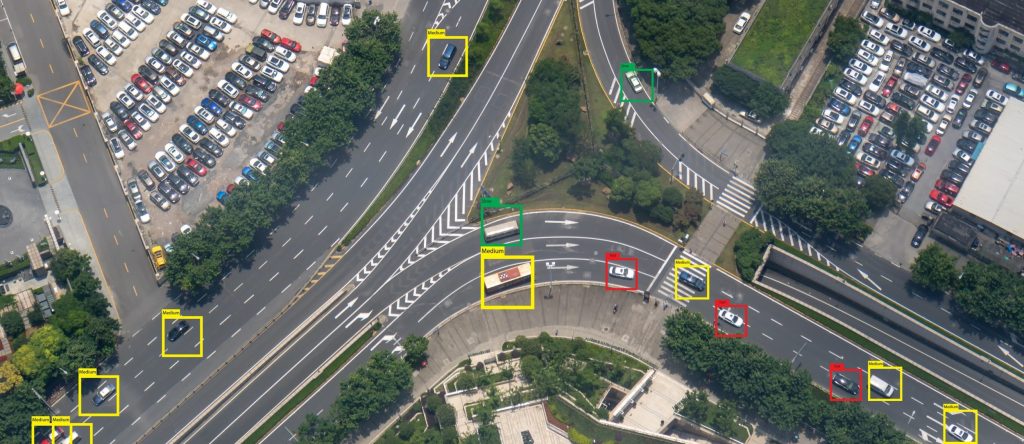
画像認識のタスクは、出力の細かさで分かれます。画像分類は画像1枚にラベル1つ、物体検出は物体ごとに矩形(バウンディングボックス)とラベル、セグメンテーションは画素ごとにラベルを返します。セグメンテーションはさらに「同じクラスの物体を別々に数えるか」で3種類に分かれます。
出力形式で比べる5つの画像認識タスク
| タスク | 出力 | 個体の区別 | 背景(空・道路) |
|---|---|---|---|
| 画像分類 | 画像1枚に1ラベル | なし | 扱わない |
| 物体検出 | 矩形+ラベル | あり | 扱わない |
| セマンティック | 全画素にクラス | なし | 扱う |
| インスタンス | 物体ごとのマスク | あり | 扱わない |
| パノプティック | 全画素にクラス+ID | あり | 扱う |
路上の写真に歩行者が3人写っている場合、セマンティックセグメンテーションは3人分の画素をまとめて「人」と塗ります。インスタンスセグメンテーションは「人1」「人2」「人3」と別々のマスクを返しますが、道路や空には何も返しません。物体検出の仕組みと手法の比較は物体検出の解説記事で扱っています。
パノプティックセグメンテーションとstuff・thingsの区別
2つを統合したのが、2018年にKirillovらが提案したパノプティックセグメンテーションです。論文は、空・道路・芝生のように数えられない領域をstuff、人・車のように数えられる物体をthingsと呼び分けました。stuffにはクラスだけを、thingsにはクラスと個体IDを全画素に割り当てます。評価指標にはPQ(Panoptic Quality)を使います。PQはクラス別に計算して平均します。各クラスのPQは、同じクラスでIoUが0.5を超えた予測と正解の組を一致(TP)とみなし、一致した組の平均IoUと、F1スコアに相当する認識の正確さを掛け合わせた値です。
用途で選ぶなら、判断は単純です。走行可能な路面の面積や腫瘍の範囲のように「どこまでが何か」が分かればよいならセマンティック。物体を数えたり1つずつ追跡したりするならインスタンス。両方が要る自動運転の地図作成などではパノプティックを使います。
画素単位の分類を実現する仕組み:エンコーダ・デコーダと解像度の復元
画像分類用のCNNは、畳み込みとプーリングを重ねて画像を小さな特徴マップに縮め、最後の全結合層で1つのラベルに集約します。セマンティックセグメンテーションでは、この「縮める」処理をエンコーダとして残し、全結合層の代わりに「元の大きさに戻す」デコーダを付けます。出力は「クラス数×高さ×幅」のスコアで、画素ごとに最大スコアのクラスを選べばラベル地図になります。
ダウンサンプリングで失われる境界の位置情報
エンコーダが解像度を落とすのは、1画素の特徴が画像の広い範囲(受容野)を見渡せるようにするためです。「これは車の一部だ」と判断するには、周囲の文脈が必要になります。代償として、細かい位置の情報が失われます。分類用のVGGやResNetは最終層で解像度が入力の1/32まで下がるため(FCN論文はこれを「32画素のストライド」と呼び、出力が粗くなる原因に挙げています)、そのまま拡大すると物体の境界がぼやけ、電柱や歩行者の手足のような細い物体が消えます。セグメンテーションの手法の多くは、この失われた位置情報をどう取り戻すかの工夫です。
解像度を戻す3つの方法:補間・転置畳み込み・プーリングインデックス
- 双線形補間:周囲の値から中間の画素を計算します。学習するパラメータが無く、FCNの最終段やDeepLabのデコーダで使われています。
- 転置畳み込み(逆畳み込みとも呼ばれます):拡大の仕方そのものを学習します。FCNは補間で初期化した転置畳み込みを学習させました。設定によっては出力に格子状のむらが出ます。
- プーリングインデックス:SegNetの方式です。エンコーダのmax poolingで「どの位置の値を残したか」を記録しておき、デコーダはその位置に値を戻して拡大します。デコーダへ渡す情報として特徴マップ全体ではなくプーリング位置を保存するため、この受け渡しに必要なメモリを抑えられます。
この3つに加えて、エンコーダの途中の高解像度な特徴マップをデコーダへ直接渡すスキップ結合が境界の精度を大きく左右します。U-Netは同じ解像度の特徴マップを丸ごと連結し、FCNは複数の解像度のスコアを足し合わせます。
受容野を広げる工夫:空洞畳み込みとピラミッドプーリング
解像度を落とさずに受容野を広げるのが空洞畳み込み(atrous convolution、dilated convolution)です。カーネルの要素の間に隙間を空けて畳み込むため、計算量を増やさずに広い範囲を見られます。DeepLabは、隙間の幅を変えた空洞畳み込みを並列に並べるASPP(Atrous Spatial Pyramid Pooling)で、大きさの違う物体を同時に捉えます。PSPNetのピラミッドプーリングも目的は同じで、特徴マップを1×1・2×2・3×3・6×6の4段階に区切ってプーリングし、画像全体の文脈を各画素の特徴に加えます。
代表モデルの系譜:FCNからSegFormer・Mask2Formerまで
主要モデルを提案年順に並べます。精度の数値は各論文が報告した最良構成の値(mIoU。U-NetのみIoU)で、データセットや事前学習の条件が違うため、行どうしを直接比べることはできません。各モデルの出典はモデル名のリンク先(arXivの原論文)です。
| モデル | arXiv初版 | 中核のアイデア | 論文の報告値 |
|---|---|---|---|
| FCN | 2014年11月 | 全結合層を畳み込みに置換 | VOC2012 test 62.2% |
| U-Net | 2015年5月 | 対称な構造と特徴の連結 | ISBI PhC-U373 IoU 92.03% |
| SegNet | 2015年11月 | プーリングインデックス | CamVid・SUN RGB-D |
| PSPNet | 2016年12月 | ピラミッドプーリング | VOC2012 test 85.4% |
| DeepLabv3+ | 2018年2月 | ASPP+軽量デコーダ | VOC2012 test 89.0% |
| SegFormer | 2021年5月 | 階層型Transformer | ADE20K val 51.8%(B5・マルチスケール) |
| Mask2Former | 2021年12月 | マスク分類で3タスク統一 | ADE20K val 57.7%(Swin-L-FaPN・マルチスケール) |
CNN系の5モデル:FCN・U-Net・SegNet・PSPNet・DeepLab
FCN(Longら)は、分類用CNNの全結合層を対応する畳み込み層に変換し、クラス別スコアを出す1×1の畳み込み層を追加することで、任意の大きさの画像から画素単位のスコアを出せるようにしました。ここから「分類用に事前学習したCNNをエンコーダに流用する」という定石が始まっています。U-Net(Ronnebergerら)は医用画像のために作られたモデルで、収縮路と拡張路が左右対称のU字を描き、同じ段の特徴マップを連結します。数十枚程度の少ない学習画像でも、データ拡張と組み合わせて高い精度を出せることを示し、医用画像や衛星画像で広く使われています。SegNetは前述のプーリングインデックスで、メモリの少ない環境を狙っています。
PSPNetとDeepLabは、空洞畳み込みでエンコーダの出力を入力の1/8〜1/16に保ったまま文脈を取り込む方向へ進みました。DeepLabv3+は、ASPPで取った文脈特徴に浅い層の特徴を合わせる軽量なデコーダを足し、境界の精度を上げています。CNN系を今から選ぶ理由は、実装と推論環境の選択肢が多いことです。torchvisionはFCNとDeepLabV3の学習済み重みを標準で配布しています。
Transformer系のSegFormer・Mask2FormerとSAMの位置づけ
2021年には、画像の特徴を自己注意で処理するSegFormerやMask2Formerが提案されました。SegFormerは位置埋め込みを使わない階層型のエンコーダと全結合層だけの軽いデコーダで構成され、学習時と違う解像度の画像でも精度が落ちにくい設計です。Mask2Formerは「画素ごとの分類」ではなく「マスクの集合を予測してそれぞれにクラスを付ける」という定式化に切り替え、セマンティック・インスタンス・パノプティックの3タスクを同じ構造で扱えるようにしました。自己注意の仕組みはTransformerの解説を参照してください。
Metaの初代Segment Anything(SAM)は、点や矩形の指示に対してマスクを切り出すモデルで、クラスを出力しません。そのままではセマンティックセグメンテーションの代わりにならず、アノテーションの下書き作りに向いています。テキストで概念を指定できる最新版についてはSAM 3の解説にまとめています。
評価指標Pixel Accuracy・mIoU・FWIoUの式と計算の落とし穴
評価指標はFCN論文が定義した4つが今も使われています。クラスiの正解画素のうちクラスjと予測された画素数をnij、クラスiの正解画素の総数をti、クラス数をnclとします。
4つの指標の式とmIoUが主指標になる理由
| 指標 | 式 | 意味 |
|---|---|---|
| Pixel Accuracy | Σi nii / Σi ti | 全画素の正解率 |
| Mean Accuracy | (1/ncl) Σi nii / ti | クラス別正解率の平均 |
| mIoU | (1/ncl) Σi nii / (ti + Σj nji − nii) | クラス別IoUの平均 |
| FWIoU | (Σk tk)−1 Σi ti nii / (ti + Σj nji − nii) | 画素数で重み付けしたIoU |
IoU(Intersection over Union)は、予測した領域と正解の領域の重なりを、両者の和集合で割った値です。取り逃がし(偽陰性)と塗りすぎ(偽陽性)の両方で下がります。mIoUはこれを全クラスで単純平均するため、画素の少ない小さなクラスを外すと大きく下がります。FWIoUは画素の多いクラスを重く扱うので、背景や道路が大半を占める画像では高めに出ます。論文や公開ベンチマークの比較にはmIoUを使い、FWIoUとPixel Accuracyは補助として見る、というのが実務での扱いです。
混同行列からmIoUを計算するnumpy実装
正解と予測のラベル地図から混同行列を作れば、4つの指標はすべてそこから計算できます。混同行列そのものの読み方は混同行列の解説で扱っています。次のコードは、背景・道路・人の3クラスで、人を背景と誤認した4×4画素の例です(numpy 2.0.2で実行)。
import numpy as np

def confusion(gt, pred, num_classes, ignore_index=255):
    mask = gt != ignore_index              # 境界などの無視ラベルを除外
    idx = num_classes * gt[mask].astype(int) + pred[mask]
    return np.bincount(idx, minlength=num_classes ** 2).reshape(num_classes, num_classes)

def scores(cm):
    tp = np.diag(cm).astype(float)
    gt_count = cm.sum(axis=1)              # 各クラスの正解画素数
    pred_count = cm.sum(axis=0)            # 各クラスの予測画素数
    with np.errstate(invalid="ignore"):    # 正解にも予測にも無いクラスは0/0=NaN
        iou = tp / (gt_count + pred_count - tp)
        acc = tp / gt_count
    freq = gt_count / cm.sum()
    return {
        "pixel_acc": tp.sum() / cm.sum(),
        "mean_acc": np.nanmean(acc),
        "mIoU": np.nanmean(iou),
        "FWIoU": (freq[freq > 0] * iou[freq > 0]).sum(),
        "IoU": iou,
    }

# 0=背景, 1=道路, 2=人 の3クラス、4x4画素の例
gt = np.array([[0, 0, 1, 1],
               [0, 0, 1, 1],
               [0, 2, 1, 1],
               [255, 2, 1, 1]])
pred = np.array([[0, 0, 1, 1],
                 [0, 0, 1, 1],
                 [0, 0, 1, 1],
                 [0, 0, 1, 1]])
s = scores(confusion(gt, pred, 3))
print({k: (np.round(v, 3).tolist() if k == "IoU" else round(float(v), 3)) for k, v in s.items()})
{'pixel_acc': 0.867, 'mean_acc': 0.667, 'mIoU': 0.571, 'FWIoU': 0.771, 'IoU': [0.714, 1.0, 0.0]}人を1画素も当てていないのに、Pixel Accuracyは86.7%あります。mIoUは人のIoUが0になるので57.1%まで下がります。Pixel Accuracyだけを見て「9割近く当たっている」と判断すると、歩行者を完全に見落とすモデルを合格にしてしまいます。
集計単位とignore_indexで数値が変わる落とし穴
同じモデルと同じ評価画像でも、集計の仕方でmIoUは変わります。自社で測った値を論文やベンチマークの値と比べる前に、次の2点を揃えてください。
- 画像ごとに平均するか、混同行列を合算するか:Cityscapesの論文はIoUのTP・FP・FNを「テストセット全体で数える」と定義しており、PASCAL VOCの評価も全画像を合算してから計算します。画像ごとにmIoUを出して平均すると、その画像に写っていないクラスを少し誤検出しただけでIoUが0になり、全体を引き下げます。上のコードで2枚の画像(人が写っていない画像に2画素の誤検出、人が大きく写った画像をほぼ正解)を評価すると、画像ごとの平均は0.733、合算では0.847でした。再現用の混同行列は、行を正解・列を予測、クラス順を背景・道路・人として、1枚目が[[6, 0, 2], [0, 8, 0], [0, 0, 0]]、2枚目が[[7, 0, 0], [0, 0, 0], [1, 0, 8]]です。
- 無視ラベルの扱い:PASCAL VOCの正解画像は物体の輪郭に値255の「境界」画素を持ち、評価から外す決まりです。255を除外しないとクラス番号の範囲外になって計算が壊れるか、境界をすべて誤りとして数えることになります。上のコードの
ignore_index=255はそのための引数です。
損失関数とクラス不均衡への対処:重み付きクロスエントロピーとDice損失
学習の基本は、画素ごとのクロスエントロピー損失を全画素で平均する方法です。ただし道路や空が画素の大半を占めるデータでは、損失の大部分が大きいクラスから来るため、電柱や信号のような小さいクラスがなかなか学習されません。対策候補は次の3つです。まず実装しやすいクラス重み付けを試し、同じ検証データで少数クラスのIoUを比較します。
- クラス重み付きクロスエントロピー:出現頻度の低いクラスに大きな重みを掛けます。PyTorchでは
nn.CrossEntropyLoss(weight=..., ignore_index=255)の1行で指定できます。 - Dice損失:予測と正解の重なり(Dice係数)を直接最大化します。2016年のV-Net論文が、前景と背景の画素数が極端に偏る3次元医用画像のために導入しました。現在も前景が画像のごく一部しかないデータで広く使われ、クロスエントロピーと足し合わせて使うのが一般的です。
- サンプリングの調整:小さいクラスを含む画像や領域を多めに切り出して学習に使います。
境界を整える後処理として、初期のDeepLabは全結合CRF(条件付き確率場)を使っていました。DeepLabv3+の論文はVOC2012で89.0%を「後処理なし」で報告しており、新しく組むモデルにCRFを前提として入れる必要はありません。
torchvisionのDeepLabV3で推論する実装手順
PyTorch公式の画像ライブラリtorchvisionには、FCN・DeepLabV3・LR-ASPPの学習済み重みが含まれています。どの重みも、COCOの画像のうちPASCAL VOCと共通の20クラスだけを使って学習されており、背景を加えた21クラスを出力します。
| 重み | mIoU | Pixel Acc | パラメータ数 |
|---|---|---|---|
| deeplabv3_resnet101 | 67.4 | 92.4 | 60,996,202 |
| deeplabv3_resnet50 | 66.4 | 92.4 | 42,004,074 |
| fcn_resnet50 | 60.5 | 91.4 | 35,322,218 |
| deeplabv3_mobilenet_v3_large | 60.3 | 91.2 | 11,029,328 |
| lraspp_mobilenet_v3_large | 57.9 | 91.2 | 3,221,538 |
数値はtorchvisionが重みのメタデータに記録しているCOCO val2017(VOCラベル)での評価値で、torchvisionのモデル一覧にも同じ値が載っています。次のコードは、パラメータ数が最も少ないDeepLabV3(MobileNetV3バックボーン)で1枚の画像を推論し、クラスごとの画素の割合を表示します。torch 2.2.2・torchvision 0.17.2のCPU環境で実行しました。2026年9月時点の最新版はtorchvision 0.29.0で、同じモデルAPIと重みが残っています。ただし、掲載コードで使うtorchvision.ioの画像読み込みAPIは0.29で非推奨になっており、新規実装ではTorchCodecへの移行を検討してください。
import torch
from torchvision.io import read_image
from torchvision.models.segmentation import (
    deeplabv3_mobilenet_v3_large,
    DeepLabV3_MobileNet_V3_Large_Weights,
)

weights = DeepLabV3_MobileNet_V3_Large_Weights.DEFAULT
model = deeplabv3_mobilenet_v3_large(weights=weights).eval()
preprocess = weights.transforms()            # リサイズと正規化を重みに合わせる

img = read_image("dog.jpg")                  # (3, H, W) の uint8 テンソル
batch = preprocess(img).unsqueeze(0)
with torch.no_grad():
    logits = model(batch)["out"]             # (1, 21, h, w):クラスごとのスコア
mask = logits.argmax(dim=1)[0]               # 画素ごとに最大スコアのクラス番号

classes = weights.meta["categories"]
ids, counts = mask.unique(return_counts=True)
for i, c in zip(ids.tolist(), counts.tolist()):
print(f"{classes[i]:<12} {c / mask.numel():.1%}")画像にはPyTorch Hubのリポジトリにあるサンプル画像(1546×1213画素の犬の写真)を使いました。dog.jpgとして作業ディレクトリに保存して実行すると、次の割合が出力されます。
__background__ 65.3%
dog 34.7%weights.transforms()は短辺を520画素に縮め、ImageNetの平均と標準偏差で正規化します。この例では入力が1×3×520×662になり、出力のoutも同じ520×662の21チャンネルで返ります。元画像の大きさでマスクが必要なら、torch.nn.functional.interpolateで拡大してからargmaxを取ってください。VOCの21クラスに無い対象(ひび割れ、農作物の病斑など)を扱うには、分類層を自分のクラス数に付け替えて追加学習します。
アノテーションコストから逆算するモデル選定と導入判断
セマンティックセグメンテーションの導入で最初に行き詰まるのは、モデルではなく教師データです。画素単位のラベルは、矩形で囲むだけの物体検出より格段に作るのに手間がかかります。
画素単位の注釈にかかる時間と作業量の目安
都市の車載画像データセットCityscapesの論文は、精密な注釈(fine)1枚あたり、注釈と品質確認に平均1.5時間以上かかったと報告しています。5,000枚で7,500時間を超える計算です。別に用意された粗い注釈(coarse)20,000枚は、境界の正確さを諦めて1枚7分未満で作られています。Cityscapesと同じ平均工数を仮定すると、1,000枚では1,500時間を超え、月160時間を注釈作業に充てる場合は約9.4人月以上になります。実際の工数は画像の複雑さと注釈基準で変わります。ラベル定義の決め方や作業者間の一致率の測り方はデータラベリングの解説で扱っています。
工数を減らす方法は2つあります。SAMのような対話型のモデルで下書きのマスクを作って人が修正する方法と、精密な注釈を評価用の少数に絞って学習には粗い注釈を使う方法です。
物体検出で足りる場面とセグメンテーションを選ばない判断
次の場面では、セマンティックセグメンテーションを選ばないでください。
- 知りたいのが個数・有無・おおよその位置だけ(入荷した箱の数、欠品棚の検知、人の侵入検知)。物体検出か画像分類で始めます。
- 同じクラスの物体が重なり、1つずつの形状まで必要(重なった果実を数えて大きさを測る)。インスタンスセグメンテーションを選びます。
- 画素単位の注釈を作る工数と予算が確保できない。必要な出力を矩形やラベルで代替できないかを先に見直します。
逆に、面積や形状そのものが判定に効く用途では、セマンティックセグメンテーションを使う価値があります。走行可能な路面の抽出、病変や臓器の範囲の計測、衛星画像からの土地被覆の集計、製品表面の傷の長さや面積の測定などです。外観検査のように古典的な画像処理で足りる場合もあるため、手法の選び分けは画像処理AIの方式選定も参考にしてください。
モデルの選択は、推論環境で決めます。エッジ端末ではLR-ASPPやMobileNet系のDeepLabV3を候補にし、対象端末・入力解像度で要求する処理速度を満たすか測定します。サーバーで精度を優先するならSegFormerやMask2Formerです。医用画像のように学習画像が数十〜数百枚しか無い場合は、U-Net系から始めるのが定石です。
よくある質問
セマンティックセグメンテーションとインスタンスセグメンテーションの違いは何ですか?
同じクラスの物体を別々に扱うかどうかが違います。セマンティックセグメンテーションは人が3人いても個体IDを付けず、全員に同じ「人」のラベルを割り当て、空や道路も含めて全画素にクラスを付けます。インスタンスセグメンテーションは「人1」「人2」「人3」と個体ごとにマスクを返しますが、空や道路のような数えられない領域は扱いません。両方をまとめたものがパノプティックセグメンテーションです。
mIoUとは何ですか?何%あれば実用になりますか?
mIoUはクラスごとのIoU(予測と正解の重なり÷和集合)を全クラスで平均した値で、セマンティックセグメンテーションの主指標です。実用の水準は用途とクラス構成で変わるため、一律の基準はありません。目安として、torchvisionのDeepLabV3(ResNet50)はCOCOのVOC20クラスで66.4%です。全体の値より、見落とすと困るクラスのIoUを個別に確認してください。
学習用の教師データ(アノテーション)には何が必要ですか?
入力画像と同じ大きさで、各画素にクラス番号を書き込んだラベル画像(マスク)が必要です。PASCAL VOC形式ではPNGの画素値がクラス番号になり、255は評価から外す境界を表します。精密な注釈は1枚に1時間以上かかることがあるため、対話型のモデルで下書きを作る、評価用だけを精密に塗るなどの工夫で工数を抑えます。
リアルタイムでセマンティックセグメンテーションを実行できますか?
できます。LR-ASPPはMobileNetV3の論文でモバイル端末向けのセグメンテーション用ヘッドとして提案されたもので、MobileNetV3と組み合わせた軽量モデルはエッジ端末での実行を想定しています。torchvisionのLR-ASPPはパラメータ数が約322万で、DeepLabV3(ResNet50)の約4,200万より1桁少なくなります。実際の処理速度は端末と入力解像度で決まるため、対象の機器で入力サイズを変えながら測ってください。
物体検出とセグメンテーションはどちらを使うべきですか?
個数や位置が分かれば足りるなら物体検出、面積や形状が判定に効くならセグメンテーションです。物体検出の注釈は矩形を引くだけなので、画素を塗るセグメンテーションより作成の工数が大幅に少なく済みます。迷う場合は物体検出で始め、矩形では判定できないケースが出てきた段階でセグメンテーションへ移るのが安全です。