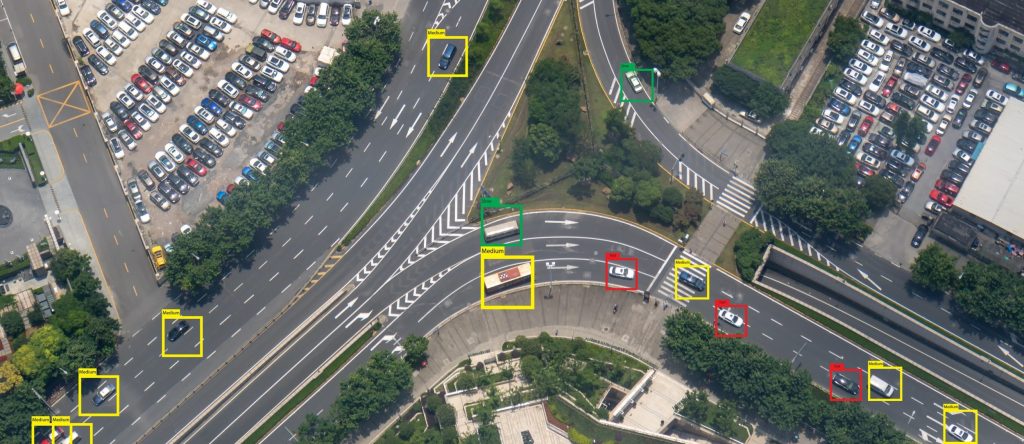
SAM 3(Segment Anything Model 3)は、Metaが2025年11月19日に公開した画像・動画のセグメンテーションモデルです。「yellow school bus」のような短い英語の名詞句を渡すと、画像や動画の中から該当する物体をすべて見つけ、1つずつマスクとIDを返します。クリックした1物体だけを切り出すSAM 2までとは、ここが決定的に違います。
この記事では、公式リポジトリ・論文(arXiv 2511.16719)・Hugging Faceの配布ページを突き合わせ、SAM 2との違い、sam3.ptの入手方法、Python(公式パッケージ・Transformers・Ultralytics)での使い方、GPUの目安、2026年3月のSAM 3.1で変わった点を整理します。
まとめ:SAM 3の要点と使い始める前に知っておくこと
- SAM 3の新機能はPCS(Promptable Concept Segmentation)。テキストや例示画像で指定した「概念」に当てはまる物体を全部切り出す。点・ボックスで1物体を切り出すSAM 2の使い方もそのまま残っている。
- モデルは848Mパラメータ。検出器(DETR系)とトラッカー(SAM 2由来)が1つの視覚エンコーダーを共有する。
- 重みはHugging Faceの
facebook/sam3でアクセス申請が承認されてから落とせる。sam3.ptは約3.45GB。 - 使い方は3通り。公式リポジトリ(Python 3.12以上・PyTorch 2.7以上・CUDA 12.6以上)、Transformers 5系の
Sam3Model、UltralyticsのSAM3SemanticPredictor。 - ライセンスはSAM 2のApache 2.0から独自のSAM Licenseに変わった。商用利用の禁止条項はないが、軍事用途などの禁止と研究発表時の明記義務がある。
- 2026年3月27日公開のSAM 3.1は、動画で多数の物体を追う処理を約7倍速くした更新版(H100 1枚・128物体の条件)。
以下、概要と仕組み、SAM 2との比較、導入手順、SAM 3.1、苦手なケースの順に説明します。
SAM 3の概要:テキストで指定した概念を全インスタンス切り出すモデル
SAM 3は、2023年のSAM(初代)、2024年のSAM 2に続くSegment Anythingシリーズの3代目です。論文の題名は「SAM 3: Segment Anything with Concepts」で、Meta Superintelligence Labsの研究チームが執筆しました。
PCSとPVS:2種類のタスクの違い
論文はSAM 3のタスクを2つに分けています。
| タスク | 入力(プロンプト) | 出力 | 対応モデル |
|---|---|---|---|
| PCS(概念を指定) | 短い名詞句・例示画像・その組み合わせ | 該当する全物体のマスクとID | SAM 3で新設 |
| PVS(物体を指定) | 点・ボックス・マスク | 指定した1物体のマスク | SAM 1・2・3 |
PCSの「概念」は、「red apple」「striped cat」程度の単純な名詞句を想定しています。例示画像(exemplar)は、画像内の1物体をボックスで囲んで「これと同じものを全部」と指示する使い方で、正例・負例の両方を渡せます。長い指示文や推論を要する問い合わせは設計の対象外で、後述のSAM 3 Agentで補います。
テキストプロンプトの言語
公式README・Transformers・Ultralyticsのドキュメントに載っている例はすべて英語の名詞句で、日本語プロンプトでの精度は公表されていません。実務では英語の名詞句で指定するのが前提です。
SAM 2とSAM 3の違い:プロンプト・出力・ライセンスの比較
公式情報をもとに、SAM 2(2.1)とSAM 3の主な差を表にまとめます。
| 項目 | SAM 2(2.1) | SAM 3 |
|---|---|---|
| 主なプロンプト | 点・ボックス・マスク | 名詞句・例示画像+点・ボックス |
| 1回の指示で得る物体数 | 1物体 | 概念に当てはまる全物体 |
| 存在判定の対象 | 追跡中の物体が映っているか | 指定した概念が画像内にあるか |
| 動画追跡 | あり | あり(トラッカーはSAM 2由来) |
| パラメータ数 | 最大の2.1 Lで224.4M | 848M |
| ライセンス | Apache 2.0 | SAM License |
| 重みの入手 | 申請不要 | Hugging Faceで申請・承認制 |
違いの本質は、「どこを切るか」を人が指示するモデルから、「何を切るか」を言葉で指示するモデルへ変わった点です。SAM 2も自動マスク生成で画像内の領域をまとめて切り出せますが、どの領域が人なのかというラベルは付きません。SAM 3なら「person」の1語で、人だけを全員切り出せます。
点・ボックス指定の精度と速度
点やボックスで1物体を切り出す従来の使い方(PVS)でも、SAM 3はSAM 2.1とほぼ同等の精度です。論文のTable 7(37データセットのSA-37ベンチマーク、平均mIoU)では次の結果でした。
| モデル | 1クリック | 3クリック | 5クリック | FPS |
|---|---|---|---|---|
| SAM 1 H | 58.5 | 77.0 | 82.1 | 41.0 |
| SAM 2.1 L | 66.4 | 80.3 | 84.3 | 93.0 |
| SAM 3 | 66.1 | 81.3 | 85.1 | 43.5 |
精度差は最大1.0ポイントですが、この表のFPSはSAM 2.1 Lの約47%です。クリックやボックスで1物体ずつ切り出す用途だけなら、SAM 2.1のほうが速く、ライセンスも緩いので、SAM 3へ移る理由は薄いと判断できます。動画の物体追跡(VOS)では差が開き、難しいMOSEv2でSAM 2.1の47.9に対してSAM 3は60.3でした(論文Table 6)。
ライセンスの変更:Apache 2.0からSAM Licenseへ
見落とされやすいのがライセンスです。SAM 2のリポジトリはApache 2.0でしたが、SAM 3は2025年11月19日付の独自ライセンス「SAM License」で配布されています。主な条件は次のとおりです。
- ロイヤリティフリーで利用・複製・改変・派生物の作成・再配布ができる(商用利用を禁じる条項はない)
- 再配布するときはSAM Licenseの写しを添え、同じ条件で配る
- SAM 3を使った研究を発表するときは、使用した旨を明記する
- 輸出管理・制裁(Trade Controls)と個人情報保護などの関係法令に従い、ITAR対象の活動や、輸出管理で禁じられた最終用途(軍事・核・諜報・武器開発に関わるものなど)に使わない
- リバースエンジニアリングを行わない、または他者に勧めない
これらの条件は社内だけで使う場合にも適用されます。防衛関連の案件や、SAM 3を組み込んだ製品を顧客へ配布する案件では、SAM Licenseの原文をもとに法務確認を先に済ませてください。ライセンスをApache 2.0のまま保ちたい場合に、SAM 2.1を動かす手順はSAM 2のインストールと画像・動画のPython実装の解説にまとめています。
SAM 3の仕組み:検出器とトラッカーが視覚エンコーダーを共有する構成
論文によると、SAM 3の約850Mパラメータのうち、視覚エンコーダーが約450M、テキストエンコーダーが約300M、検出器とトラッカーが合わせて約100Mを占めます。エンコーダーはMetaのPerception Encoder(PE)をベースにしており、54億組の画像とテキストで対照学習されています。
- 検出器:DETR系のモデルで、テキスト・位置(点やボックス)・例示画像を条件として、該当する物体のボックスとマスクを出す。物体検出の基本的な考え方は物体検出の仕組みと代表手法の比較、DETR系のリアルタイム検出はRT-DETRの解説が参考になります。
- プレゼンスヘッド:「その概念が画像内に存在するか」を位置の特定とは別に判定する新しい部品。「白いユニフォームの選手」と「赤いユニフォームの選手」のように似た指示の区別を強くする。
- トラッカー:SAM 2のメモリ付きエンコーダー・デコーダーを受け継ぎ、動画のフレーム間でマスクを追う。追跡中にクリックでマスクを修正する機能もここが担う。
検出と追跡を分けた理由について、READMEは「タスク間の干渉を最小にし、データ量に応じて効率よく伸ばせる設計」と説明しています。
学習データSA-Coとベンチマークの数値
SAM 3の性能は、Metaが新しく構築したSA-Co(Segment Anything with Concepts)データに支えられています。
SA-Coデータセットの規模と作り方
| データ | 中身 | 規模 |
|---|---|---|
| SA-Co/HQ | 人とAIの検証を経た高品質画像 | 520万枚・400万名詞句 |
| SA-Co/SYN | 人を介さない合成ラベル | 3,800万名詞句・14億マスク |
| SA-Co/EXT | 既存データセットに負例を追加 | 外部の公開データセット |
| SA-Co/VIDEO | 動画 | 5.25万本・46.7万マスクレット |
ラベル付けは4段階の「データエンジン」で進められました。Llama 3.2をファインチューニングした「AI検証器」がマスクの品質と漏れの有無を判定し、人手は失敗しやすい事例に集中させる仕組みです。論文によると、AI検証器の導入でアノテーションの処理量はおよそ2倍になりました。名詞句の候補は、Wikidataを基にした2,240万ノードの概念体系からも抽出しています。人とAIでラベル付けを分担する考え方は、データラベリングの設計と自動化でも扱っています。
評価用のSA-Coベンチマークは、論文(v2)では20.7万の固有概念を含むと書かれていますが、READMEでは「270K unique concepts」と表記されています。引用するときはどちらの数字かを明示してください。
画像・動画ベンチマークの結果
主要指標のcgF1は、マスクの位置精度(pmF1)と「対象が画像内にいるか」の判定精度(IL_MCC)を掛け合わせた値で、論文は「cgF1 = 100 × pmF1 × IL_MCC」と定義しています。READMEの表から、SA-Co/Goldでのインスタンスセグメンテーションの値を抜き出しました。
| モデル | SA-Co/Gold cgF1 | LVIS マスクAP |
|---|---|---|
| 人間 | 72.8 | – |
| SAM 3 | 54.1 | 48.5 |
| OWLv2(LVISで一部学習) | 24.6 | 43.4 |
| DINO-X | 21.3 | 38.5 |
| Gemini 2.5 | 13.0 | – |
既存の手法に対して2倍以上の値で、READMEは人間の75〜80%の水準と説明しています。COCOのボックス検出APは56.4でした。物体の数え上げでも、CountBenchの正答率はSAM 3が93.8%で、Gemini 2.5 Proの92.4%を上回っています(論文Table 4)。
動画では差がまだ大きく、SA-VのテストセットでcgF1が人間53.1に対してSAM 3は30.3、YT-Temporal-1Bでは71.2に対して50.8でした。画像ほど人間に迫ってはいない点は押さえておくべきです。mIoUやAPといった指標の計算方法は、セマンティックセグメンテーションの解説で詳しく説明しています。
SAM 3の使い方:ダウンロードから推論まで
Pythonから使う経路は、公式パッケージ、Hugging Face Transformers、Ultralyticsの3つです。どれを使う場合も、最初に重みの利用申請が必要です。
モデルのダウンロード:Hugging Faceでのアクセス申請
重みはHugging Faceのfacebook/sam3リポジトリで配布されていますが、アクセスは手動承認制(gated)です。手順は次のとおりです。
- Hugging Faceにログインし、
facebook/sam3のページで利用条件に同意して申請する - 承認後、Hugging Faceの設定画面でアクセストークンを発行する
- 作業環境で
hf auth loginを実行してトークンを登録する
2026年9月27日時点のファイル一覧では、公式パッケージとUltralytics用のsam3.ptが3,450,062,241バイト、Transformers用のmodel.safetensorsが3,439,938,512バイトです。ComfyUIなどのツールでmodels/sam3/sam3.ptのような配置を求められるのは、このsam3.ptを指しています。SAM 3.1の重みは別リポジトリのfacebook/sam3.1にあり、こちらも申請が必要です。
ブラウザで動作だけ確かめたい場合は、Metaが公開しているWebデモ「Segment Anything Playground」を使えます。
公式リポジトリ(sam3パッケージ)での推論
READMEが挙げる前提条件は、Python 3.12以上、PyTorch 2.7以上、CUDA 12.6以上に対応したGPUです。手順はリポジトリをクローンして編集可能モードでインストールする方法です。
conda create -n sam3 python=3.12
conda activate sam3
pip install torch==2.10.0 torchvision --index-url https://download.pytorch.org/whl/cu128
git clone https://github.com/facebookresearch/sam3.git
cd sam3
pip install -e .PyPIにもpip install sam3で入るパッケージがあります。作者表記はMeta AI Researchですが、PyPI上の管理者はRoboflowの組織アカウントで、2026年9月27日時点の最新は2026年5月26日公開の0.1.4です。0.1.4には、SAM 3.1のObject Multiplexを動かすコードが含まれていません。READMEも、SAM 3.1を使うならリポジトリの最新コードを取り直して入れ直すよう指示しています。SAM 3.1まで使う予定なら、最初からgit clone経由で入れるのが無難です。
画像にテキストプロンプトを渡す最小のコードは次のとおりです(READMEの例を基にしています)。初回実行時に、承認済みのトークンで重みが自動ダウンロードされます。
from PIL import Image
from sam3.model_builder import build_sam3_image_model
from sam3.model.sam3_image_processor import Sam3Processor

model = build_sam3_image_model()
processor = Sam3Processor(model)

image = Image.open("street.jpg")
state = processor.set_image(image)
output = processor.set_text_prompt(state=state, prompt="yellow school bus")

masks, boxes, scores = output["masks"], output["boxes"], output["scores"]
print(len(masks), "objects")動画はbuild_sam3_video_predictor()でセッションを開始し、add_promptで任意のフレームにテキストを渡します。MP4ファイルかJPEG連番のフォルダを入力にできます。
Hugging Face Transformersでの推論
Transformersには、SAM 3が公開日の2025年11月19日に追加されました。モデルのコードはv5.0.0rc0以降に含まれ、v4.57系にはありません。Transformers 5系と、device_map="auto"に必要なAccelerateをインストールしてください(pip install -U transformers accelerate)。
import torch
from PIL import Image
from transformers import Sam3Model, Sam3Processor

model = Sam3Model.from_pretrained("facebook/sam3", device_map="auto")
processor = Sam3Processor.from_pretrained("facebook/sam3")

image = Image.open("kitchen.jpg").convert("RGB")
inputs = processor(images=image, text="handle", return_tensors="pt").to(model.device)

with torch.no_grad():
    outputs = model(**inputs)

results = processor.post_process_instance_segmentation(
    outputs,
    threshold=0.5,
    mask_threshold=0.5,
    target_sizes=inputs.get("original_sizes").tolist(),
)[0]
print(len(results["masks"]), "objects")
結果には、元画像サイズのマスク、xyxy形式のボックス、信頼度スコアが入ります。点やボックスで1物体を切り出すSAM 2と同じ使い方はSam3TrackerModel、動画のPCSはSam3VideoModelと、クラスが分かれています。Transformersの土台となるフレームワークについてはPyTorchの解説をご覧ください。
Ultralyticsでの推論
YOLOと同じUltralyticsの書き方で使いたい場合は、pip install -U ultralyticsで導入します。他のUltralyticsモデルと違い、sam3.ptは自動ダウンロードされないため、Hugging Faceで取得したファイルを作業ディレクトリに置きます。テキスト指定にはSAM3SemanticPredictorを使います。
from ultralytics.models.sam import SAM3SemanticPredictor

overrides = {"conf": 0.25, "task": "segment", "mode": "predict",
             "model": "sam3.pt", "quantize": 16, "save": True}
predictor = SAM3SemanticPredictor(overrides=overrides)
predictor.set_image("path/to/image.jpg")
results = predictor(text=["person", "bus", "glasses"])
"quantize": 16はFP16で推論する指定です。Ultralyticsのドキュメントは、CLIPパッケージをUltralytics版(git+https://github.com/ultralytics/CLIP.git)へ入れ替える手順も案内しています。SAM("sam3.pt")に点やボックスを渡した場合は、SAM 2と同じく指定位置の1物体だけが切り出されます。
3つの導入経路の選び方
| 経路 | 向いている用途 | SAM 3.1 |
|---|---|---|
| 公式リポジトリ | 動画追跡・SAM 3 Agent・学習 | 対応(git clone版) |
| Transformers 5系 | 既存のHugging Face推論基盤へ組み込む | 重みの配布なし |
| Ultralytics | YOLOと同じAPIで試作する | 画像のみ対応 |
Transformersの表で「重みの配布なし」としたのは、facebook/sam3.1のファイル一覧にsam3.1_multiplex.ptしかなく、Transformers用のmodel.safetensorsが無いためです(2026年9月27日時点)。Ultralyticsはsam3.1_multiplex.ptを画像用の予測器で読めますが、Object Multiplexによる動画追跡には未対応で、動画にはsam3.ptを使うよう案内しています。
GPU・VRAMの目安と推論速度
Metaは必要なVRAM量を公表していません。見積もりの材料になる公式の数値は次のとおりです。
- 重みファイルは約3.45GB(848Mパラメータ×4バイト=FP32相当)。FP16やBF16で読み込めば重みは約半分になるが、推論時の中間データが別に必要
- 論文の計測では、H200 1枚で100物体以上を含む画像1枚を30ミリ秒で処理する
- 動画は追跡する物体数に比例して計算量が増える。30FPSを保つため、Webデモでは2台のH200で10物体、4台で28物体、8台で64物体まで並列化している
- Ultralyticsの比較表は、96GBのRTX PRO 6000で計測したもの
CUDA対応GPUを前提としているのはMetaの公式リポジトリで、Mac(Apple Silicon)やCPUだけの環境は挙げられていません。Transformers版のドキュメントにはCUDAの必須要件がなく、CPU上でも読み込めますが、CPUでの速度の公称値はありません。必要な計算量は、画像の単発推論と動画の多物体追跡とで大きく違います。動画で多数の物体を追う用途は、GPUの台数か後述のSAM 3.1で対処する前提で設計してください。
SAM 3.1の変更点:Object Multiplexによる多物体追跡の高速化
2026年3月27日に公開されたSAM 3.1は、動画処理を中心とした更新です。SAM 3は追跡する物体を1つずつ独立して処理するため、物体数に比例して遅くなっていました。SAM 3.1のObject Multiplexは、物体を固定容量の「バケット」にまとめて共有メモリで同時に処理し、重複する計算を減らします。
- H100 1枚・128物体の条件で、2025年11月版のSAM 3と比べて約7倍の高速化
- CPUとGPU間の同期の削減、
torch.compile対応の強化、後処理とエンコーダーのバッチ化 - SA-Co/VEvalではYT-Temporal-1BのcgF1が50.8から52.9に上がった一方、SmartGlassesは36.4から36.3とほぼ横ばい
- VOSでは7ベンチマーク中6つで改善し、MOSEv2は60.3から62.3
公式リポジトリの最新コードでは、build_sam3_predictor(version="sam3.1")で3.1、version="sam3"で従来版を選べます。画像のセグメンテーション精度を上げる更新ではないため、画像だけを扱うならSAM 3のままで困りません。
SAM 3 Agent:複雑な指示文をMLLMと組み合わせて処理する仕組み
SAM 3単体は、単純な名詞句しか受け付けません。「青いベストを着た一番左の子ども」のような指示を扱うために、論文とリポジトリはSAM 3 Agentという使い方を示しています。マルチモーダルLLM(MLLM)が指示文を名詞句に分解してSAM 3へ渡し、返ってきたマスクを見て条件に合うものを選ぶ、という処理を納得できるまで繰り返す仕組みです。
リポジトリのノートブック(examples/sam3_agent.ipynb)は、vLLMで立てたQwen3-VL-8B-Thinkingを例にしていますが、APIで呼べる他のMLLMにも差し替えられます。論文では、参照表現や推論型セグメンテーションのデータで追加学習しないまま、ReasonSegやOmniLabelで既存手法を上回ったと報告しています。
SAM 3が苦手なケースと採用を見送る判断
論文のB節は、SAM 3の制限を具体的に挙げています。導入を決める前に、自社の用途が次に当てはまらないかを確認してください。
- 専門的で細かい概念:航空機の機種名や医療用語のような細分類は、ゼロショットでは汎化しにくい。サーモ画像のような特殊な画像領域ではさらに難しい。
- 属性の多い指示:扱えるのは属性が1〜2個程度の短い名詞句まで。長い参照表現はSAM 3 Agentが必要になる。
- 多数物体の動画追跡:物体数に比例して計算量が増え、物体間で文脈を共有しないため、混雑した場面では取り違えが起きうる(SAM 3.1で速度面は改善)。
一方で論文は、少量の人手ラベルでファインチューニングすれば新しい概念や領域に素早く適応できること、SAM 3とAI検証器で作った合成データだけでも新領域の精度を上げられることを示しています。専門領域で使うなら、ゼロショットの精度だけで見切らず、少量の追加ラベルで学習し直した後の精度で評価するのが筋です。
採用を見送るべき場面もはっきりしています。
- 検出したいクラスが固定で、リアルタイム性が必要なライン検査:YOLO系やRT-DETRなど専用に学習した軽量モデルのほうが速く、運用も単純
- 人がクリックで1物体ずつ切り出すだけのツール:論文の計測(SA-37)ではSAM 2.1 Lのほうが約2倍速く、ライセンスもApache 2.0
- ITAR対象の活動や、輸出管理で禁じられた軍事目的などの最終用途に当たる案件:SAM Licenseの条文1.b.vで禁止されている
逆に、未知の物体を言葉で指定して大量の画像からマスクを作りたい場面、たとえば学習データ作成の下ごしらえや、動画から特定の物体を探して追う作業では、SAM 3が最も効果を発揮します。
よくある質問
SAM 3とは何ですか?
Metaが2025年11月19日に公開したセグメンテーションモデルです。短い英語の名詞句や例示画像で指定した概念に当てはまる物体を、画像・動画の中からすべて切り出してマスクとIDを返します。パラメータ数は848Mです。
SAM 3は日本語のプロンプトで使えますか?
公式ドキュメントの例はすべて英語の名詞句で、日本語での精度は公表されていません。「person」「red car」のように英語で指定してください。
SAM 3は商用利用できますか?
SAM Licenseに商用利用を禁じる条項はなく、ロイヤリティフリーで利用・改変・再配布できます。ただしITAR対象の活動や輸出管理で禁じられた最終用途(軍事・諜報など)での利用禁止、再配布時のライセンス添付、研究発表時の明記といった条件があります。SAM 2(Apache 2.0)とは条件が異なるので、製品に組み込む場合は条文を確認してください。
SAM 3はMacやCPUだけの環境で動きますか?
Metaの公式リポジトリはCUDA 12.6以上に対応したGPUを前提にしており、MacやCPU環境は挙げられていません。Transformers経由ならCUDAは必須要件になっておらず、CPU上でも読み込めます。ただしCPUでの速度は公表されていないため、動作確認はブラウザのSegment Anything Playground、本格的な処理はクラウドのGPUインスタンスで行うのが現実的です。
SAM 3とSAM 3.1はどちらを使えばよいですか?
動画で多数の物体を追うならSAM 3.1です。H100 1枚・128物体の条件で約7倍速くなっています。画像だけを扱う用途では精度差がほぼないため、Transformersで使える点も含めてSAM 3で十分です。